AI研究:arXiv论文,2026年9月3日
单条训练查询即可覆盖完整LLM蒸馏数据集71.5%的效果
一篇新的arXiv论文发现,单条训练查询可达到完整蒸馏数据集71.5%的状态覆盖率,且16条多样化的查询即可与全量数据训练持平。论文认为,瓶颈在于学生模型吸收监督信号的速度。
用单条查询运行同策略蒸馏,它会在数百个训练步中持续改进。一篇于2026年9月3日提交至arXiv的论文报告称,跨越不同任务领域和模型家族,这单个样本就能找回完整数据集所产生的绝大部分收益。
同策略蒸馏(OPD)将学生模型自身的采样轨迹与教师模型提供的稠密、token级监督配对。该系列此前的工作集中于算法本身的行为,训练数据的作用则悬而未决。这篇论文把数据问题压到最小值:只用一条查询训练,观察学生模型的表现。
一条查询,大部分收益
这个头条数字并非全量数据训练的一小部分。单样本OPD在数百个训练步中持续改进,并弥合了与在论文所测试的全部数据上训练之间的大部分差距。若纯粹当作效率结果来读,这让蒸馏显得便宜;若按论文的框架来读,它抛出了一个更棘手的问题:那些多出来的数据究竟在起什么作用。
状态覆盖率衡量的是什么
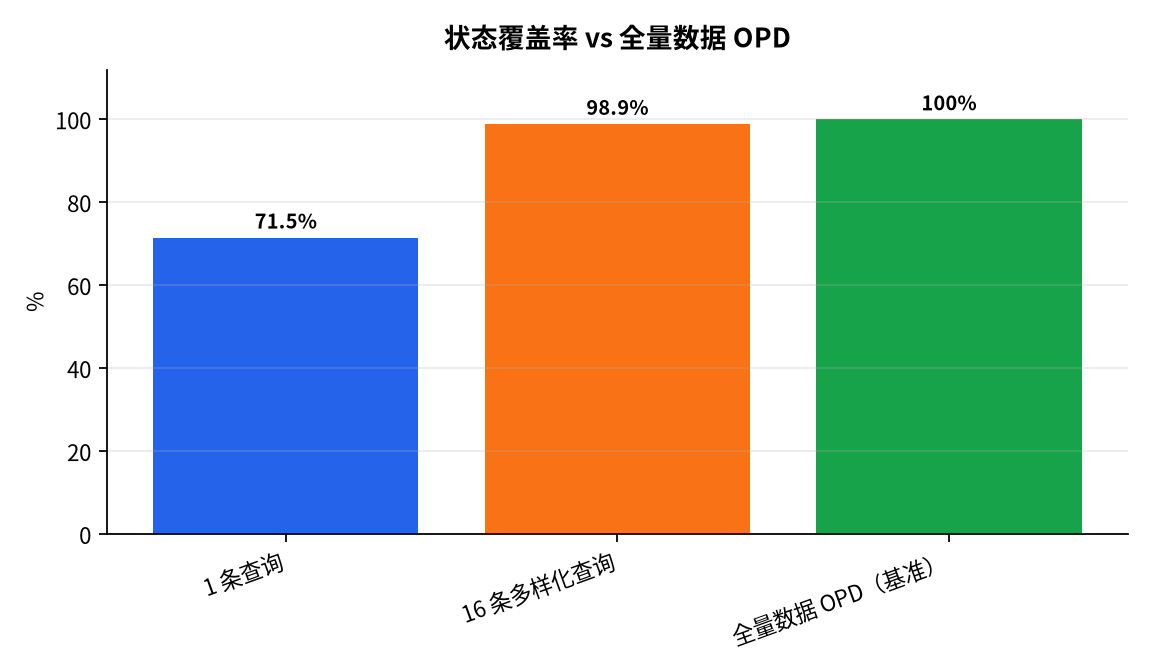
为解释这一结果,论文考察了学生模型在训练过程中访问的状态,并将状态覆盖率定义为:全量数据OPD运行所到达的状态中,某一给定查询集的采样轨迹也到达的那一部分所占的比例。单条查询已经覆盖了其中71.5%,而其中大部分覆盖在前100步内就已完成。
此后的增长来自多样性,而非数量。加入语义各异的查询会同时提升覆盖率与验证准确率,直到16条查询达到98.9%,与全量数据训练持平。
| 训练集 | 状态覆盖率 | 报告结果 |
|---|---|---|
| 单条查询 | 71.5% | 大部分覆盖率在前100步内达到 |
| 16条语义各异的查询 | 98.9% | 与全量数据OPD持平 |
| 每个领域16条多样化查询(多教师OPD) | 未报告 | 与全量数据多教师训练持平 |
学生模型的吸收速度慢于数据的到达速度
如果一条查询就提供了几乎全部覆盖率,为什么单样本训练仍需要数百步才能改进?论文的回答是:无论OPD是在一条查询上训练还是在全量数据集上训练,学生与教师之间的对齐都以大致相同的速度放缓。即便是一组固定不变、被交付之后不再变化的状态,也需要数百步才能被吸收。
这种错配得出了论文直言不讳的诊断:OPD“数据过饱,算法饥渴”。它的采样轨迹能迅速暴露广泛的监督信号,而学生模型吸收这些监督的速度却不断衰减。
模板与域外提示词也接近
两项压力测试挑战了“查询的内容才是有效成分”这一想法。几乎不含任务实质内容的轻内容模板,接近真实查询的基线水平;域外的WildChat查询也是如此。论文的结论是,任务内容与所诱导出的状态覆盖可以相互分离,这意味着一个几乎不含任务内容的查询集,仍能让学生模型接近那些真正重要的状态。
该条目未能确定的部分
论文没有指明任何任务领域或模型家族,也未报告任何独立复现。覆盖率的衡量也只有一个参照, , 全量数据OPD所访问的状态,因此该指标描述的是规模更小的运行触及了那次运行多大范围的状态,而非衡量“多少监督才算足够”的绝对标准。
同样的模式也延伸到多教师OPD:每个领域16条语义多样化的查询即可与全量数据训练持平。论文明确表达的期望是,这些结果能把研究重心引向该方法的步效率,并促使人们重新审视数据,以及该方法近期在前沿后训练中取得成功的背后机制。
对于一种论文将近期前沿成功部分归因于数据的技术而言,把训练集削减到16条查询却仍能与基线持平,是个奇怪的结果。论文的解读是:更多数据改变的是监督信号到达的速度,而不是学生模型能吸收多少。如果这一判断成立,下一轮改进将属于训练循环,而非语料。
每天早晨用 3 分钟掌握科技要闻
每个工作日一封邮件,只讲真正重要的 AI 与科技动态。