主权 AI · 德国的语言模型
Aleph Alpha 需要 4 万亿个德语 token。开放网络只能提供 1.94 万亿。
Aleph Alpha 的消融实验为德语预训练设定了 4 万亿 token 的下限。六个最大的免费德语数据集总计约 1.94 万亿,其中约 6000 亿来自机器翻译的英语。
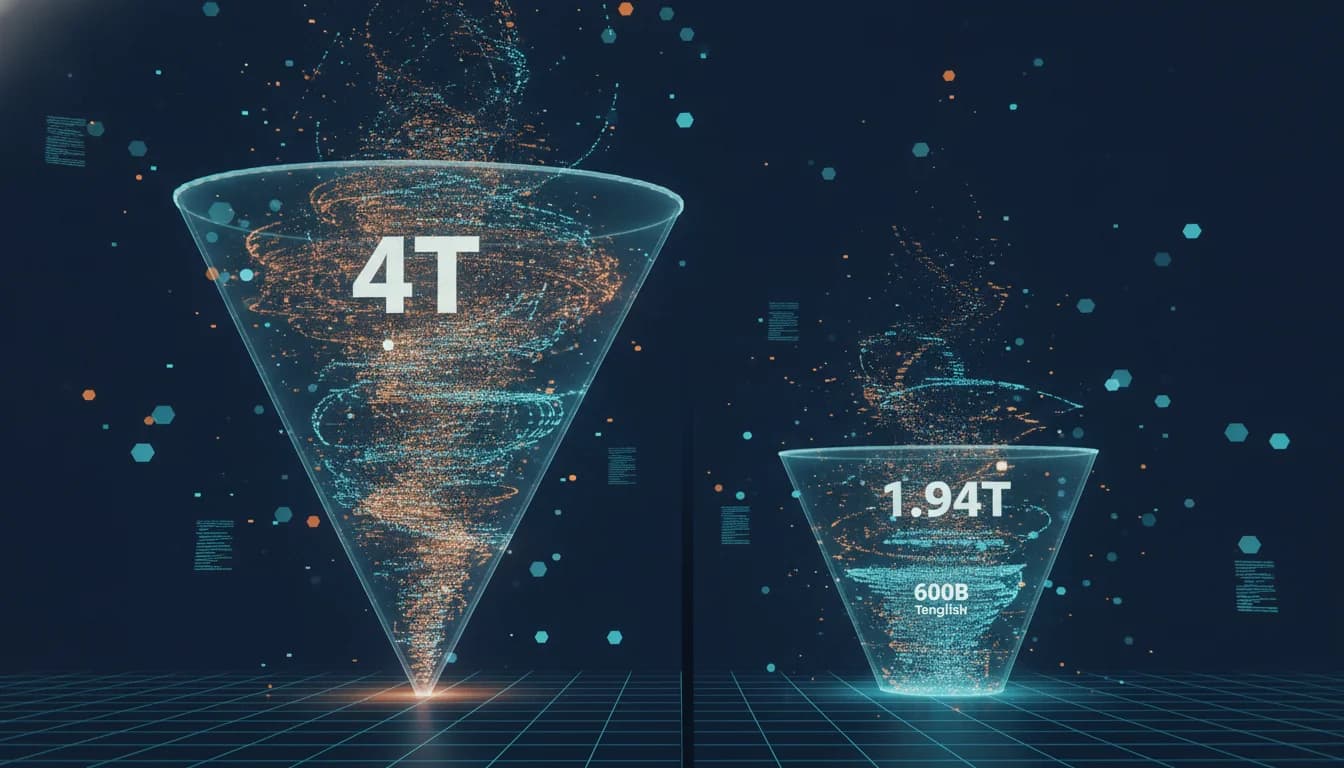
前沿语言模型在成为建模问题之前,首先是一个数据问题;而对德语来说,这个数据问题有一个具体数字。Aleph Alpha 表示,一次德语训练至少需要 4 万亿个德语 token, , 这是其消融研究设定的下限,研究表明 20% 的德语占比在其德语基准测试上表现最佳。以目前的策展水平,开放网络只能提供其中约一半。
六个免费数据集构成了德语模型开发者可以直接取用的主体。
| 数据集 | 规模(十亿 token) | 最新源数据 |
|---|---|---|
| HPLT 3.0(德语部分) | 609 | 2025 |
| KletterMix(ClimbMix 的机器翻译) | 500 | 2024 |
| FineWeb2(德语部分) | 378 | 2024 |
| FinePDFs(德语部分) | 177 | 2025 |
| German Commons | 154 | 2025 |
| MT-Nemotron-CC(Nemotron-CC 的机器翻译) | 117 | 2024 |
它们合计约 1.94 万亿 token, , Aleph Alpha 通过将每个数据集的未压缩字节数除以四得出这一数字,以便使各数据集之间可比。按该公司的估算,如今训练一个顶尖模型需要超过 20 万亿 token,它援引的是 Nemotron 3 Super。该公司还依据 Muennighoff 等人关于重复训练的研究:重复使用同一批文档在约四个 epoch 之后就不再带来收益,因此德语目标可以依赖一个更小的语料池,但不能是任意小。
上限,而非总量
有两项制约会压低这 1.94 万亿。其一是来源:其中约 6000 亿来自 KletterMix 和 MT-Nemotron-CC,是对英语语料的机器翻译,而非德语原生文本。其二是重叠:HPLT 3.0、FineWeb2 和 German Commons 都源自 Common Crawl,因此去除重复后,它们的规模并不能简单相加。
还有时效性问题。每个免费数据集都是快照,由截至某一固定日期的抓取内容汇编而成,然后被冻结;FineWeb2 不包含 2024 年 4 月之后抓取的任何内容。Aleph Alpha 举的失败例子很直白:如果不接入检索或工具,基于这些数据训练的模型会自信地回答说,奥拉夫·朔尔茨是德国总理。较新的版本会把截止日期推近当下,但也只是几个月,而且只有在发布方推出新版本时才会如此。
该公司围绕这一节奏搭建了自己的 Common Crawl 流水线。它是增量的,因此新的快照可以直接并入,无需重新处理此前的数据;而且流水线按语言参数化。目前存在 120 多个快照,大约每月新增一个,每个快照包含约 1 亿份德语文档,约 500 亿原始 token。去重和启发式规则会大幅削减这一数量,Aleph Alpha 也直言其取舍:每一步过滤都以数量为代价换取质量。
合成数据是乘数,不是加数
Aleph Alpha 使用合成数据,但仍将其视为配角。所谓改写(reformulation),即用 LLM 将现有德语文档改写成百科条目、问答对话或教科书段落,为其 Aleph-Alpha-GermanWeb 数据集生成了约 10 亿 token,素材取自 FineWeb2 的德语文本。这种方法以正确的方式做到了低成本:模型需要的是好的德语,而非深厚的德语世界知识,它把同样的事实换用多种表述包装起来。它无法创造原本不存在于其中的知识。
翻译是另一半,而它引入了一种偏斜。机器翻译出的德语通常合乎语法,却滑入该公司所说的“翻译腔”(translationese),即逐字直译习语的习惯:'Drive safe!' 被译成 'Fahre sicher!',而不是地道的 'Komm gut an!'。更深层的问题在于分布。由英语翻译而来的语料带有英语网络的地理和机构偏向,因此主要用它训练的模型,说的虽是德语,描述的世界却像是美国的。Aleph Alpha 指出,Pleias 和 NVIDIA 之所以将 Nemotron-Personas 数据集建立在国家人口普查统计之上,也是出于同样的原因。
反方观点也获得了一席之地。ÜberWeb 的作者认为,知识确实能跨语言迁移。但 Aleph Alpha 援引 ÜberWeb 以及 Gaber 等人更近期的研究指出,要实现良好的迁移,需要细致的多语言策展,可能还需要有针对性的翻译,以避免损害各语言的表现。这两种方法都无法取代原生的德语网络数据,因为二者都以它为前提。
一个调错的过滤器,八分之七的文档丢失
流水线是最具可迁移性的部分。阈值、词表和分类器都可配置,而德语是继英语之后加入的第一种语言。按英语校准的词长过滤器, , Gopher 将其界限设为 3 到 10 个字符, , 会丢弃大量合格的德语内容:官方德语文本平均每个词 11.7 个字符,而其英文翻译为 5.7 个字符。FineWeb2 推荐的德语区间 0 到 15 将拒收率从 0.3% 降至 0.02%;以每次抓取约 1 亿份文档计算,这意味着约 30 万份普通文档得以保留而非被丢弃。
停用词过滤器的对比更为鲜明。若使用英语的 Gopher 词表,它会丢弃超过 87% 送抵该环节的德语文档;而使用德语词表时仅为 0.6%,相差约 150 倍。
合规检查贯穿同样的环节。Aleph Alpha 会依据欧盟委员会的《假冒与盗版观察名单》和由图卢兹第一大学(Université Toulouse Capitole)维护的 UT1 黑名单过滤 URL,并将个人可识别信息, , 包括电子邮件、电话号码、IP 地址和银行账号, , 替换为特殊 token。像 'name [at] domain' 这样的混淆形式也会被计入。其代价是可以量化的:在自身的个人信息(PII)基准测试上,该模型比用同样数据但不做 PII 替换训练的模型低约 5 个百分点,而其他基准测试则保持稳定。
每一个非英语模型都要付的账单
德语的案例读起来与其说是一份产品发布,不如说是对每一种非英语语言的成本估算。Aleph Alpha 表示,迄今它已策展并生成超过 2 万亿个高质量德语 token,填补了开放网络所能提供与前沿模型所需之间的大部分缺口。下一种语言是否更便宜,与其说取决于更好的合成模型,不如说取决于该语言的网络上有多少原生文本。
- 来源 : Aleph Alpha needed 4 trillion German tokens. The open web offers 1.94. — 2026-09-08
每天早晨用 3 分钟掌握科技要闻
每个工作日一封邮件,只讲真正重要的 AI 与科技动态。