数据库 · AI
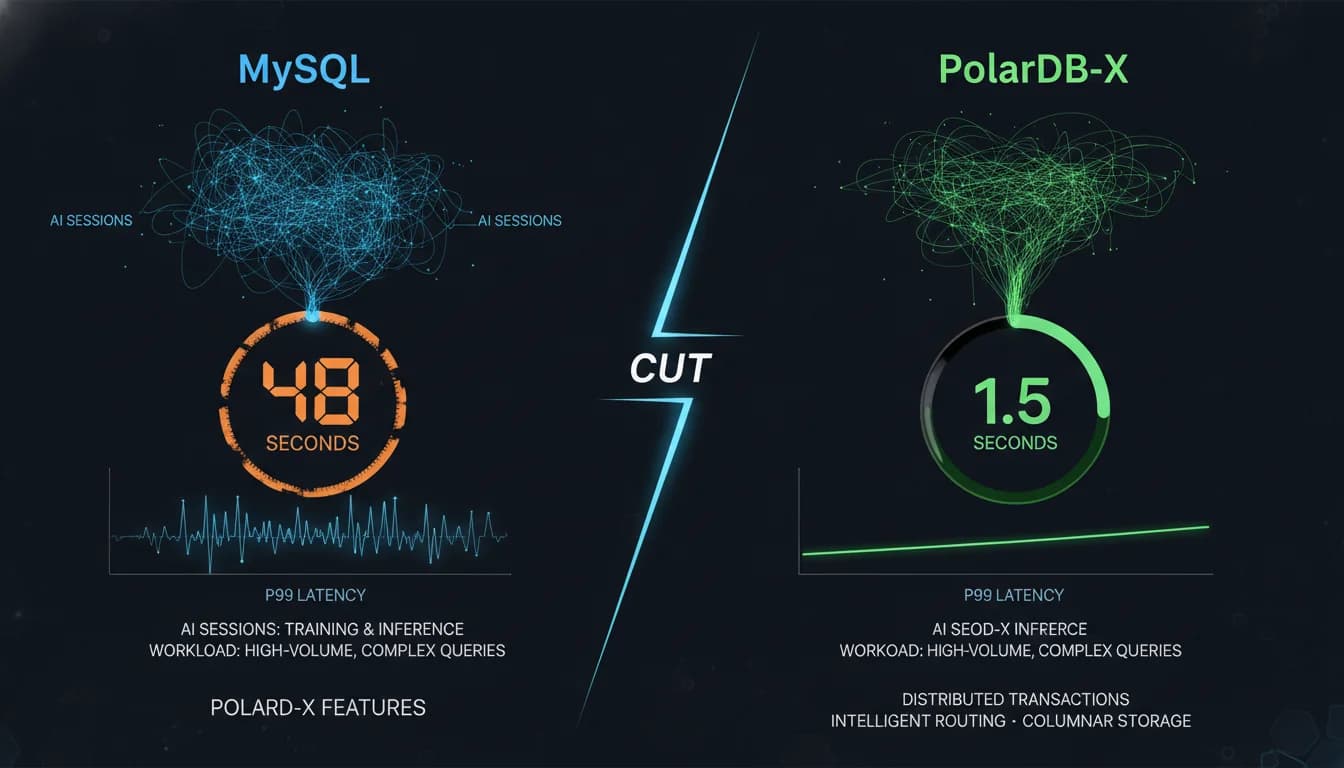
MySQL的P99在AI会话中达到48秒。PolarDB-X将其降至1.5
MySQL在AI会话存储中是个异类,对于现代对话产生的MB级blob没有标准路径。PolarDB-X外部列将blob路由到OSS,同时保留InnoDB事务和普通SQL,公布的基准测试显示写入尾部延迟从48.7秒骤降至1.5秒。
AI助手改变了数据库行的形态。编码代理会话将多轮对话、代码片段和工具调用结果打包成数百个堆叠的轮次;聊天机器人必须跨越数天记住上下文。一条消息现在从KB增长到MB,会话量从数百万增长到数亿。阿里云PolarDB-X团队称这是MySQL至今没有标准答案的存储问题。
该文回顾了GPT-3时代4K token的上下文窗口、GPT-4的128K,以及Claude Opus 4的1M token。团队写道,今年一个会话快照约为几MB,明年也许达到十MB。
MySQL是唯一没有标准路径的生态系统
PostgreSQL、MongoDB和Redis都有经过验证的AI会话解决方案:jsonb是LangGraph的默认检查点器,MongoDB支撑LlamaIndex的聊天存储,Redis提供了官方的agent记忆服务器。这篇博客的对比表引人注目的是缺席者:MySQL。
MySQL的两条主流路径都是以一个问题换另一个问题。将内容存储在InnoDB LONGTEXT列中简单且具有事务性,但大列与普通字段共享数据路径:随着规模增长,binlog膨胀、复制压力增大、缓冲池被挤占。只在MySQL中保留元数据、将负载放在OSS上虽然降低了成本,但将事务一致性、生命周期管理和双系统操作推给了应用层。
PolarDB-X的答案是一个关键字。在LONGTEXT列上添加EXTERNALIZE后,INSERT、SELECT和DELETE均保持不变,文章强调MyBatis和JPA等ORM,以及LangChain和LlamaIndex等框架无需任何适配。引擎在计算层按列大小路由。约100 KB的列直接进入OSS,只有blob地址进入binlog,因此LOB页分裂和复制瓶颈消失;OSS写入失败仍会回滚,后台GC清理孤儿数据。约1 KB的列落入本地InnoDB暂存表,写入延迟与普通插入一致,后台flush将其批量迁移到OSS。删除也移入引擎:GC遵循InnoDB的purge机制和全局最小活动事务视图,取代了手写对账脚本。
基准测试差距:从48.7秒降至1.5秒
在相同schema、256个并发客户端下测得,写入表现如下:
| 列大小 | InnoDB 平均 / P99 | 外部列 平均 / P99 |
|---|---|---|
| 200 KB | 152 ms / 1.2 s | 101 ms / 138 ms |
| 500 KB | 374 ms / 2.3 s | 137 ms / 425 ms |
| 1 MB | 929 ms / 4.8 s | 262 ms / 774 ms |
| 2 MB | 5.6 s / 48.7 s | 514 ms / 1.5 s |
在2 MB时,InnoDB的P99尾部延迟达到48.7秒,而外部列保持在1.5秒。文章的结论是:1 KB列写入速度与直接使用InnoDB相当,100 KB列在高并发下将InnoDB甩开一个数量级,因此外部列应成为默认选择。
这些是厂商自测数据,这一提醒值得保留,博客本身也列出了两个坦诚的边界。冷读需要付出代价:缓存未命中时从OSS获取需要20+ ms。外部列无法建索引,因此不支持二级索引、范围扫描或LIKE查询。这适合按主键整体获取的内容,而session_id等可搜索字段保持索引。据该文所述,外部文本列的全文本索引已在路线图上。
为写后读模式而生
AI会话以写后立即读为主导,此时应用为下一轮重新组装上下文。四级缓存服务这一模式:本地内存、本地SSD、通过RPC访问的另一节点缓存,以及作为最终回退的OSS。热读据称与普通列查询无异。一条助手回复甚至可以拆分为内容、附件、tool_calls和reasoning等多个独立的外部化列,每列都有自己的缓存条目,因此DeepSeek-R1或Qwen QwQ等模型完整输出的思维链几乎永久地存在于OSS上。
RAG知识库、审计日志和媒体文件也符合这一模式。阿里云此前已推进这一方向:其工程师早先记录过在PolarDB for PostgreSQL上将pgvector扩展到十亿向量规模、毫秒级响应。
独立验证仍是悬而未决的问题。MySQL生态系统的缺口真实存在,以至于团队多年来一直在构建自己的补偿逻辑。PolarDB-X提供的是一个关键字,让引擎承担应用过去背负的复杂性。这在其他规模下是否依然成立,只有生产流量才能回答。
每天早晨用 3 分钟掌握科技要闻
每个工作日一封邮件,只讲真正重要的 AI 与科技动态。