الذكاء الاصطناعي السيادي · نماذج اللغة الألمانية
ألفا ألفا احتاجت 4 تريليونات رمز ألماني. الويب المفتوح يوفر 1.94.
يضع عمل الاستئصال الذي أجرته ألفا ألفا حداً أدنى قدره 4 تريليونات رمز للتدريب المسبق باللغة الألمانية. تبلغ مجموع أكبر ست مجموعات بيانات ألمانية مجانية نحو 1.94 تريليون، وحوالي 600 مليار منها مترجمة آلياً من الإنجليزية.
Emmanuel Fabrice Omgbwa Yasse بمساعدة الذكاء الاصطناعي
2026-09-17 · قراءة 5 دقائق
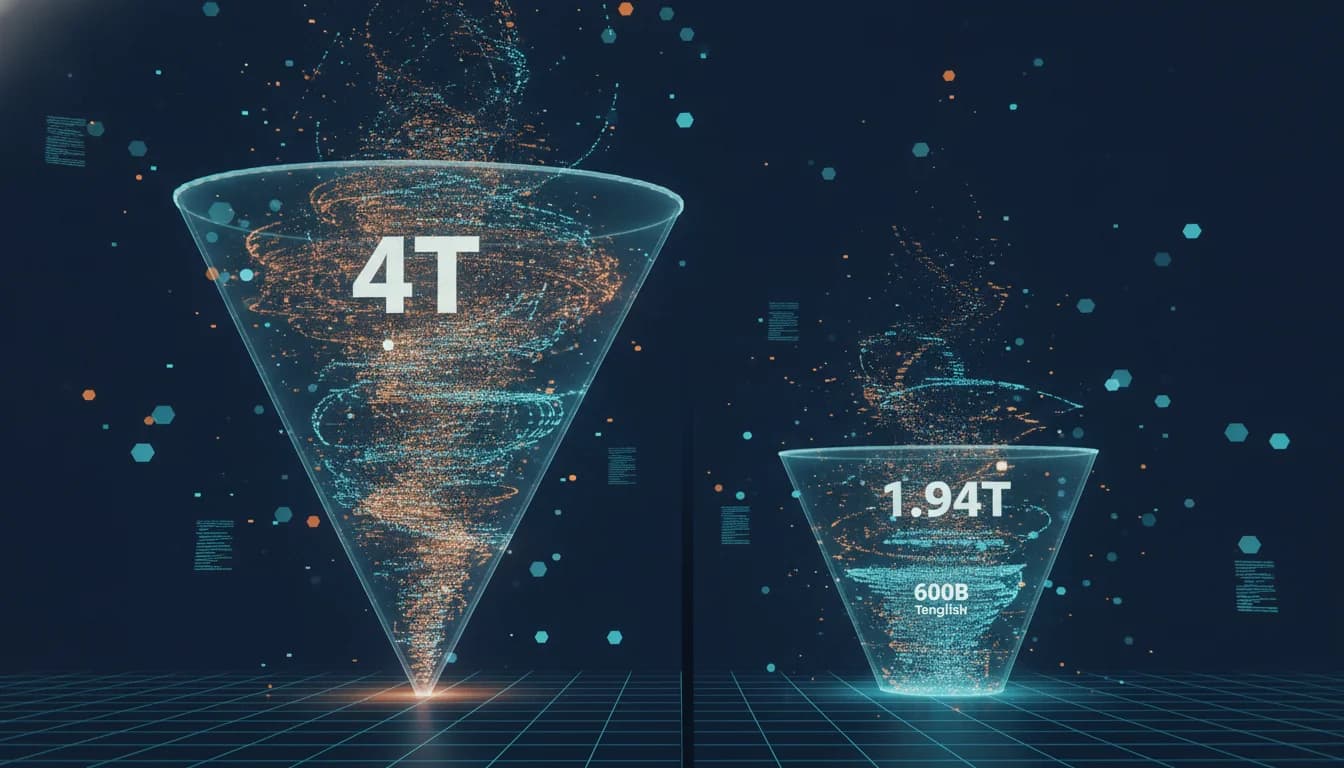
نموذج اللغة المتقدم هو في الغالب مشكلة بيانات قبل أن يكون مشكلة نمذجة، وبالنسبة للألمانية فإن مشكلة البيانات لها رقم. تقول ألفا ألفا إن جولة تدريب باللغة الألمانية تحتاج إلى 4 تريليونات رمز ألماني على الأقل، وهو حد أدنى وضعته دراسات الاستئصال الخاصة بها من خلال إظهار أن حصة ألمانية بنسبة 20% تحقق أفضل أداء على معاييرها الألمانية. الويب المفتوح، كما هو منسق حالياً، يوفر حوالي نصف ذلك.
تشكل ست مجموعات بيانات مجانية الجزء الأكبر مما يمكن لباني نموذج ألماني أن يحصل عليه من الرف.
| مجموعة البيانات | الحجم (مليار رمز) | أحدث بيانات المصدر |
|---|---|---|
| HPLT 3.0 (الجزء الألماني) | 609 | 2025 |
| KletterMix (ترجمة آلية لـ ClimbMix) | 500 | 2024 |
| FineWeb2 (الجزء الألماني) | 378 | 2024 |
| FinePDFs (الجزء الألماني) | 177 | 2025 |
| German Commons | 154 | 2025 |
| MT-Nemotron-CC (ترجمة آلية لـ Nemotron-CC) | 117 | 2024 |
يبلغ مجموعها معاً حوالي 1.94 تريليون رمز، وهو رقم توصلت إليه ألفا ألفا بقسمة حجم البايت غير المضغوط لكل مجموعة بيانات على أربعة لتكون الأعداد قابلة للمقارنة. يتطلب تدريب نموذج متقدم اليوم أكثر من 20 تريليون رمز، بحسب تقدير الشركة، نقلاً عن Nemotron 3 Super. كما تستند إلى Muennighoff وزملائه بشأن التكرار: يتوقف إعادة استخدام نفس المستندات عن تحقيق مكاسب بعد حوالي أربع دورات، لذا يمكن للهدف الألماني أن يعتمد على مخزون أصغر، ولكن ليس صغيراً بشكل تعسفي.
سقف، وليس مجموعاً
هناك قيدان يخفضان 1.94 تريليون. الأول هو المصدر: حوالي 600 مليار منها، موزعة بين KletterMix و MT-Nemotron-CC، تأتي من الترجمة الآلية لمجموعات النصوص الإنجليزية بدلاً من النصوص الألمانية الأصلية. الثاني هو التداخل: HPLT 3.0 و FineWeb2 و German Commons كلها مشتقة من Common Crawl، لذا فإن أحجامها لا تُضاف ببساطة بمجرد إزالة التكرارات.
ثم هناك الحداثة. كل مجموعة بيانات مجانية هي لقطة، تُجمع من عمليات الزحف حتى تاريخ محدد ثم تُجمّد؛ FineWeb2 لا تحتوي على أي شيء تم الزحف إليه بعد أبريل 2024. مثال ألفا ألفا على الفشل صريح. عند التدريب بدون استرجاع أو وصول إلى الأدوات، سيجيب نموذج مبني على تلك البيانات بثقة أن أولاف شولتس هو المستشار. تدفع الإصدارات الأحدث نقطة القطع أقرب إلى الحاضر، ولكن بأشهر، وفقط عندما تنشر الجهة إصداراً جديداً.
بنت الشركة خط أنابيب Common Crawl الخاص بها حول هذا الإيقاع. إنه تدريجي، لذا يمكن دمج لقطة جديدة دون إعادة معالجة ما سبق، وهو مُعامل حسب اللغة. يوجد أكثر من 120 لقطة ويصل حوالي واحدة كل شهر، تحمل كل منها نحو 100 مليون مستند ألماني، أي حوالي 50 مليار رمز خام. تقلص إزالة التكرار والاستدلالات ذلك بشدة، وتذكر ألفا ألفا المقايضة بوضوح: كل خطوة تصفية تشتري الجودة على حساب الكمية.
البيانات الاصطناعية تُضاعف، ولا تُضيف
تستخدم ألفا ألفا البيانات الاصطناعية ولا تزال تتعامل معها كدور مساند. إعادة الصياغة، حيث يعيد نموذج لغوي كبير كتابة المستندات الألمانية الموجودة إلى مدخلات موسوعية أو حوارات Q&A أو مقاطع كتب مدرسية، أنتجت حوالي مليار رمز لمجموعة بيانات Aleph-Alpha-GermanWeb الخاصة بها، مستمدة من نص FineWeb2 الألماني. الطريقة رخيصة بالطريقة الصحيحة: يحتاج النموذج إلى ألمانية جيدة، وليس معرفة ألمانية عميقة بالعالم، وهو يكسو نفس الحقائق في صيغ كثيرة. لا يمكنه إنشاء معرفة لم تكن موجودة بالفعل.
الترجمة هي النصف الآخر، وهي تستورد تحيزاً. الألمانية المترجمة آلياً عادة ما تكون نحوية لكنها تنزلق إلى ما تسميه الشركة الترجمة الحرفية، وهي عادة ترجمة التعابير كلمة بكلمة: 'Drive safe!' تصبح 'Fahre sicher!' بدلاً من التعبير الاصطلاحي 'Komm gut an!' القضية الأعمق هي التوزيع. مجموعة نصوص مترجمة من الإنجليزية تحمل الميل الجغرافي والمؤسسي للويب الإنجليزي، لذا فإن نموذجاً مدرباً في الغالب عليها يتعلم التحدث بالألمانية عن عالم يبدو أمريكياً. تعتمد Pleias و NVIDIA مجموعات بيانات Nemotron-Personas الخاصة بهما على إحصاءات التعداد الوطني للسبب نفسه، كما تلاحظ ألفا ألفا.
تحظى الحجة المضادة بسماع. يرى مؤلفو ÜberWeb أن المعرفة تنتقل عبر اللغات. لكن ألفا ألفا تستشهد بكل من ÜberWeb وعمل أحدث من Gaber وزملائه للإشارة إلى أن النقل الجيد يتطلب تنسيقاً متعدد اللغات دقيقاً، وربما ترجمة موجهة، لتجنب الإضرار بالأداء لكل لغة. لا يحل أي من النهجين محل بيانات الويب الألمانية العضوية، لأن كليهما يفترضها مسبقاً.
مرشح واحد سيئ الضبط، يفقد سبعة من كل ثمانية مستندات
خط الأنابيب هو الجزء الأكثر قابلية للنقل. العتبات وقوائم الكلمات والمصنفات قابلة للتكوين، وكانت الألمانية أول لغة تُضاف بعد الإنجليزية. مرشح طول الكلمة المعاير على الإنجليزية، حيث وضع Gopher حدوداً من 3 إلى 10 أحرف، يطرح الألمانية الجيدة: يبلغ متوسط النثر الألماني الرسمي 11.7 حرفاً لكل كلمة مقابل 5.7 لترجمته الإنجليزية. الفاصل الألماني الموصى به من FineWeb2 من 0 إلى 15 يخفض معدل الرفض من 0.3% إلى 0.02%، وهو ما يعني عبر حوالي 100 مليون مستند لكل زحف الاحتفاظ بحوالي 300,000 مستند عادي بدلاً من التخلص منها.
مرشح كلمات التوقف أكثر حدة. عند تطبيقه بقائمة Gopher الإنجليزية، يتخلص من أكثر من 87% من المستندات الألمانية التي تصل إليه، مقابل 0.6% مع القائمة الألمانية، أي حوالي 150 ضعفاً.
تمر الامتثال عبر نفس المراحل. تصفي ألفا ألفا عناوين URL مقابل قائمة المراقبة للمنتجات المقلدة والقرصنة التابعة للمفوضية الأوروبية والقائمة السوداء UT1 التي تديرها جامعة تولوز كابيتول، وتستبدل المعلومات الشخصية القابلة للتعريف، بما في ذلك رسائل البريد الإلكتروني وأرقام الهواتف وعناوين IP وأرقام الحسابات المصرفية، برموز خاصة. تُحتسب أيضاً الأشكال المشوشة مثل 'name [at] domain'. تُقاس التكلفة: على معايير PII الخاصة بها يسجل النموذج حوالي 5 نقاط مئوية أقل من نموذج مدرب على نفس البيانات بدون استبدال PII، بينما تصمد المعايير الأخرى.
الفاتورة لكل نموذج غير إنجليزي
تبدو الحالة الألمانية أقرب إلى تقدير تكلفة لكل لغة ليست الإنجليزية من كونها إعلان منتج. تقول ألفا ألفا إنها نسقت وأنشأت أكثر من 2 تريليون رمز ألماني عالي الجودة حتى الآن، مما يسد الكثير من الفجوة بين ما يوفره الويب المفتوح وما يحتاجه نموذج متقدم. ما إذا كانت اللغة التالية أرخص يعتمد أقل على نماذج اصطناعية أفضل وأكثر على مقدار النص العضوي الذي يحتويه ويب تلك اللغة.
- المصدر : Aleph Alpha needed 4 trillion German tokens. The open web offers 1.94. — 2026-09-08
أهم أخبار التقنية في 3 دقائق كل صباح
بريد إلكتروني واحد، كل يوم عمل، بما يهم فعلاً في الذكاء الاصطناعي والتقنية.