أبحاث الذكاء الاصطناعي: ورقة على arXiv، 3 سبتمبر 2026
استعلام تدريبي واحد يغطي 71.5% مما تغطيه مجموعة بيانات تقطير كاملة لنموذج لغوي كبير
تجد ورقة جديدة على arXiv أن استعلاماً تدريبياً واحداً يبلغ 71.5% من تغطية الحالات التي تحققها مجموعة بيانات تقطير كاملة، وأن 16 استعلاماً متنوعة تضاهي التدريب على البيانات الكاملة. وترى الورقة أن عنق الزجاجة هو مدى سرعة استيعاب النموذج الطالب للإشراف.
Emmanuel Fabrice Omgbwa Yasse بمساعدة الذكاء الاصطناعي
2026-09-17 · قراءة 4 دقائق
درّب عملية تقطير وفق السياسة على استعلام واحد وستظل تتحسن لمئات الخطوات. تشير ورقة مقدمة إلى arXiv في 3 سبتمبر 2026 إلى أن هذا المثال الواحد يستعيد معظم المكسب الذي تنتجه مجموعة بيانات كاملة، عبر مجالات المهام وعائلات النماذج.
يقترن التقطير وفق السياسة (OPD) بمخرجات النموذج الطالب نفسه مع إشراف كثيف على مستوى الرموز من نموذج معلم. وركّزت أعمال سابقة في السلسلة على كيفية تصرف الخوارزمية، تاركة دور بيانات التدريب مفتوحاً. وتدفع هذه الورقة مسألة البيانات إلى حدها الأدنى عبر التدريب على استعلام واحد ومراقبة ما يفعله النموذج الطالب.
استعلام واحد، ومعظم المكسب
الرقم الرئيسي ليس جزءاً صغيراً من تشغيل البيانات الكاملة. يستمر OPD بالطلقة الواحدة في التحسن لمئات الخطوات ويسد معظم الفجوة نحو التدريب على كل ما اختبرته الورقة. إذا قُرئ كنتيجة كفاءة خالصة، فإن ذلك يجعل التقطير يبدو رخيصاً. وإذا قُرئ بالطريقة التي تؤطره الورقة، فإنه يطرح سؤالاً أصعب حول ما كانت البيانات الإضافية تفعله أصلاً.
ما الذي تقيسه تغطية الحالات
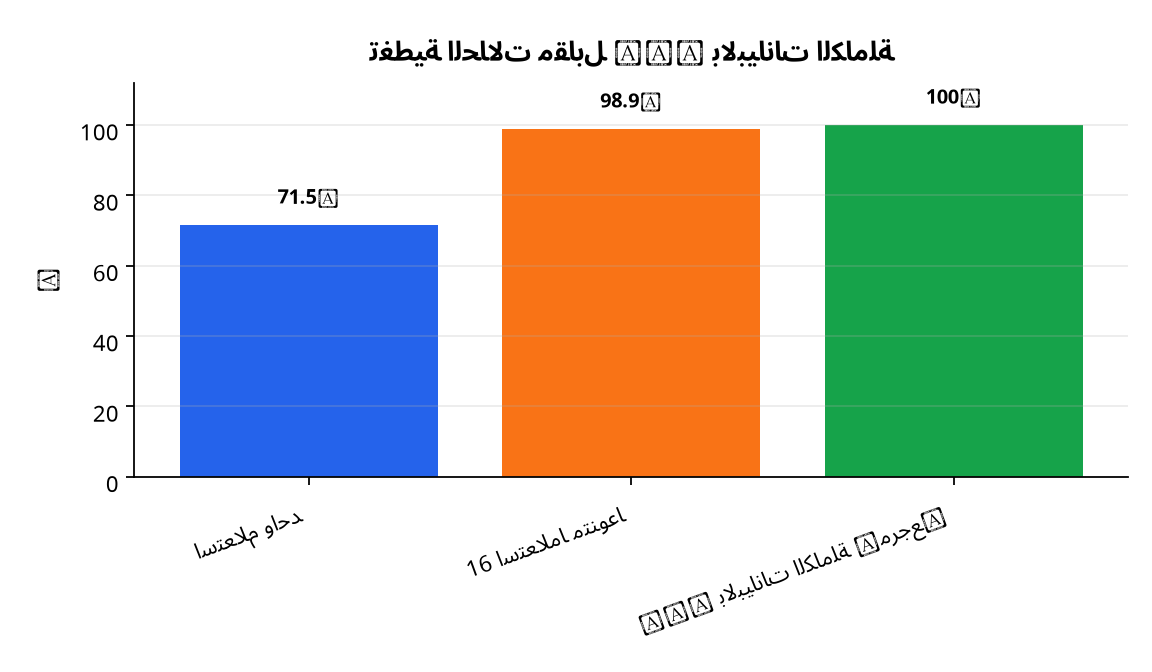
لتفسير النتيجة، تنظر الورقة إلى الحالات التي يزورها النموذج الطالب أثناء التدريب وتعرّف تغطية الحالات بأنها نسبة الحالات التي تصل إليها عملية OPD على البيانات الكاملة والتي تصل إليها أيضاً مخرجات مجموعة استعلامات معينة. ويغطي استعلام واحد بالفعل 71.5% منها، ويصل معظم هذه التغطية خلال أول 100 خطوة.
النمو بعد ذلك يأتي من التنوع، لا من الحجم. إضافة استعلامات متمايزة دلالياً ترفع التغطية ودقة التحقق معاً، حتى تبلغ 16 استعلاماً نسبة 98.9% وتضاهي التدريب على البيانات الكاملة.
| مجموعة التدريب | تغطية الحالات | النتيجة المبلّغ عنها |
|---|---|---|
| استعلام واحد | 71.5% | معظم التغطية تُبلغ خلال أول 100 خطوة |
| 16 استعلاماً متمايزة دلالياً | 98.9% | تضاهي OPD على البيانات الكاملة |
| 16 استعلاماً متنوعاً لكل مجال (OPD متعدد المعلمين) | غير مبلّغ عنه | تضاهي التدريب متعدد المعلمين على البيانات الكاملة |
النموذج الطالب يستوعب أبطأ مما تصل البيانات
إذا كان استعلام واحد يوفّر تقريباً كل التغطية، فلماذا لا يزال التدريب بالطلقة الواحدة يحتاج إلى مئات الخطوات ليتحسن؟ جواب الورقة هو أن المحاذاة بين النموذج الطالب والمعلم تتباطأ بالوتيرة نفسها تقريباً سواء درب OPD على استعلام واحد أو على مجموعة البيانات كاملة. وحتى مجموعة حالات ثابتة، تُسلّم ولم تعد تتغير، تستغرق مئات الخطوات لاستيعابها.
ينتج عن هذا التباين التشخيص الصريح للورقة: OPD "مُفرط التغذية بالبيانات لكنه مُجوّع على مستوى الخوارزمية". فمخرجاته تكشف إشرافاً واسعاً بسرعة، بينما يستوعب النموذج الطالب ذلك الإشراف بمعدل متضائل.
القوالب والمطالبات خارج المجال تقترب
هناك اختباران للإجهاد يدفعان ضد فكرة أن محتوى الاستعلام هو المكوّن الفعّال. فالقوالب الخفيفة المحتوى، التي تحمل قدراً ضئيلاً من جوهر المهمة، تقترب من خط الأساس للاستعلام الحقيقي. وكذلك تفعل استعلامات WildChat خارج المجال. وتخلص الورقة إلى أن محتوى المهمة وتغطية الحالات المستحثة يمكن أن ينفصلا، ما يعني أن مجموعة استعلامات يمكن أن تكون شبه خالية من المهمة ومع ذلك تقرّب النموذج الطالب من الحالات المهمة.
ما لا يحسمه الإدراج
لا تسمي أي مجالات مهام أو عائلات نماذج، ولا تبلغ عن تكرار مستقل. كما تُقاس التغطية مقابل مرجع واحد، هو الحالات التي تزورها OPD على البيانات الكاملة، لذا تصف المقياس مقدار ما تصل إليه عملية أصغر من أراضي ذلك التشغيل بدلاً من قياس مطلق لمقدار الإشراف الكافي.
يمتد النمط نفسه إلى OPD متعدد المعلمين، حيث تضاهي 16 استعلاماً متنوعاً دلالياً لكل مجال التدريب على البيانات الكاملة. والأمل المعلن للورقة هو أن تعيد هذه النتائج توجيه العمل نحو كفاءة الخطوات في الطريقة، وتدفع إلى نظرة جديدة على البيانات والآليات الكامنة وراء نجاحاتها الأخيرة في التدريب اللاحق على الحدود.
تقليص مجموعة تدريب إلى 16 استعلاماً ومضاهاة خط الأساس نتيجة غريبة لتقنية تنسب الورقة نجاحاتها الأخيرة على الحدود جزئياً إلى البيانات. وقراءتها هي أن مزيداً من البيانات يغيّر مدى سرعة وصول الإشراف، لا مقدار ما يستطيع النموذج الطالب استيعابه. وإذا صح ذلك، فإن الجولة التالية من التحسينات تخص حلقة التدريب، لا المدونة النصية.
- المصدر : One training query covers 71.5% of what a full LLM distillation dataset does — 2026-09-03
أهم أخبار التقنية في 3 دقائق كل صباح
بريد إلكتروني واحد، كل يوم عمل، بما يهم فعلاً في الذكاء الاصطناعي والتقنية.