IA soberana · Los modelos de lenguaje de Alemania
Aleph Alpha necesitaba 4 billones de tokens en alemán. La web abierta ofrece 1,94.
El trabajo de ablación de Aleph Alpha fija un mínimo de 4 billones de tokens para el preentrenamiento en alemán. Los seis mayores conjuntos de datos alemanes gratuitos suman unos 1,94 billones, y aproximadamente 600.000 millones de ellos proceden de traducción automática del inglés.
Emmanuel Fabrice Omgbwa Yasse Asistido por IA
2026-09-17 · 5 min de lectura
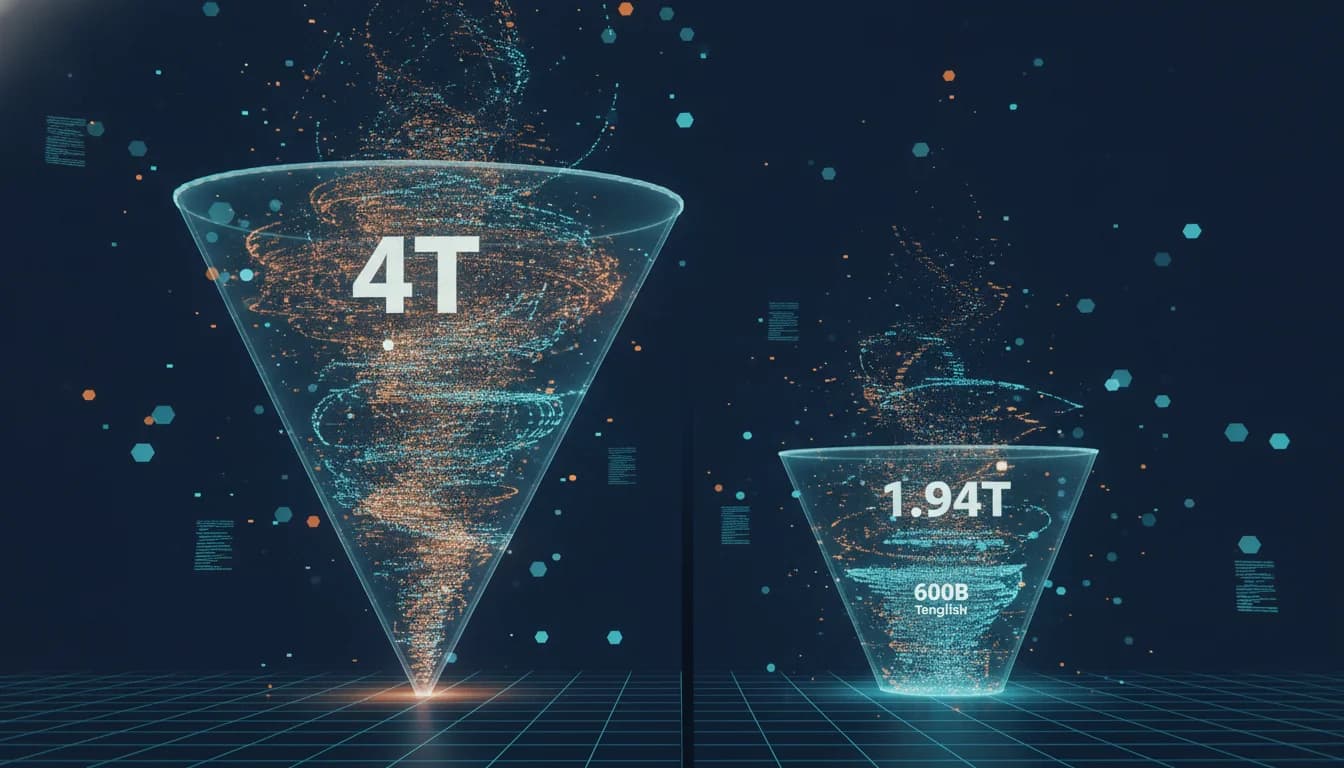
Un modelo de lenguaje frontera es, antes que un problema de modelado, sobre todo un problema de datos, y en el caso del alemán ese problema de datos tiene una cifra. Aleph Alpha afirma que una ejecución de entrenamiento en alemán necesita al menos 4 billones de tokens en alemán, un mínimo que sus estudios de ablación establecieron al demostrar que una proporción del 20% de alemán rinde mejor en sus benchmarks en alemán. La web abierta, tal como está curada actualmente, ofrece aproximadamente la mitad.
Seis conjuntos de datos gratuitos constituyen la mayor parte de lo que un desarrollador de modelos en alemán puede tomar ya hecho.
| Conjunto de datos | Tamaño (miles de millones de tokens) | Datos de origen más recientes |
|---|---|---|
| HPLT 3.0 (porción en alemán) | 609 | 2025 |
| KletterMix (traducción automática de ClimbMix) | 500 | 2024 |
| FineWeb2 (porción en alemán) | 378 | 2024 |
| FinePDFs (porción en alemán) | 177 | 2025 |
| German Commons | 154 | 2025 |
| MT-Nemotron-CC (traducción automática de Nemotron-CC) | 117 | 2024 |
En conjunto suman aproximadamente 1,94 billones de tokens, una cifra a la que Aleph Alpha llega dividiendo entre cuatro el tamaño sin comprimir en bytes de cada conjunto de datos para que los recuentos sean comparables. Entrenar un modelo puntero hoy requiere más de 20 billones de tokens, según los cálculos de la empresa, que cita Nemotron 3 Super. También se apoya en Muennighoff et al. a propósito de la repetición: reutilizar los mismos documentos deja de dar rendimiento después de unas cuatro épocas, de modo que el objetivo alemán puede recurrir a un fondo más pequeño, pero no a uno arbitrariamente pequeño.
Un techo, no un total
Dos restricciones rebajan esos 1,94 billones. La primera es la procedencia: unos 600.000 millones, repartidos entre KletterMix y MT-Nemotron-CC, proceden de la traducción automática de corpus en inglés y no de texto nativo en alemán. La segunda es el solapamiento: HPLT 3.0, FineWeb2 y German Commons derivan todos de Common Crawl, por lo que sus tamaños no se suman sin más una vez eliminados los duplicados.
Luego está la frescura. Cada conjunto de datos gratuito es una instantánea, ensamblada a partir de rastreos hasta una fecha fija y después congelada; FineWeb2 no contiene nada rastreado después de abril de 2024. El ejemplo del fallo que pone Aleph Alpha es contundente. Entrenado sin recuperación ni acceso a herramientas, un modelo construido con esos datos responderá con seguridad que Olaf Scholz es canciller. Las versiones más recientes acercan el corte al presente, pero por meses, y solo cuando el editor publica una nueva versión.
La empresa construyó su propio pipeline de Common Crawl en torno a ese ritmo. Es incremental, de modo que una nueva instantánea puede incorporarse sin reprocesar lo anterior, y está parametrizado por idioma. Existen más de 120 instantáneas y llega aproximadamente una cada mes, cada una con unos 100 millones de documentos en alemán, alrededor de 50.000 millones de tokens en bruto. La deduplicación y las heurísticas los recortan con dureza, y Aleph Alpha expone el compromiso sin rodeos: cada paso de filtrado compra calidad a costa de cantidad.
Los datos sintéticos multiplican, no suman
Aleph Alpha utiliza datos sintéticos y aun así los trata como un papel secundario. La reformulación, en la que un LLM reescribe documentos alemanes existentes como entradas enciclopédicas, diálogos de preguntas y respuestas o pasajes de libros de texto, produjo unos 1.000 millones de tokens para su conjunto de datos Aleph-Alpha-GermanWeb, extraído del texto en alemán de FineWeb2. El método es barato en el buen sentido: el modelo necesita buen alemán, no un conocimiento profundo del mundo en alemán, y viste los mismos hechos con muchas formulaciones. No puede crear conocimiento que no estuviera ya ahí.
La traducción es la otra mitad, y conlleva un sesgo. El alemán traducido automáticamente suele ser gramatical, pero incurre en lo que la empresa llama translationese, la costumbre de verter los modismos palabra por palabra: 'Drive safe!' se convierte en 'Fahre sicher!' en lugar del idiomático 'Komm gut an!'. El problema de fondo es la distribución. Un corpus traducido del inglés arrastra la inclinación geográfica e institucional de la web en inglés, de modo que un modelo entrenado sobre todo con él aprende a hablar alemán de un mundo que parece estadounidense. Pleias y NVIDIA basan sus conjuntos de datos Nemotron-Personas en estadísticas de censos nacionales por la misma razón, señala Aleph Alpha.
El contraargumento también tiene su espacio. Los autores de ÜberWeb sostienen que el conocimiento sí se transfiere entre idiomas. Pero Aleph Alpha cita tanto ÜberWeb como trabajos más recientes de Gaber et al. para sugerir que una buena transferencia requiere una curación multilingüe cuidadosa, y posiblemente traducción específica, a fin de no perjudicar el rendimiento por idioma. Ninguno de los dos enfoques sustituye a los datos orgánicos de la web en alemán, porque ambos los presuponen.
Un filtro mal ajustado, siete de cada ocho documentos perdidos
El pipeline es la parte más transferible. Los umbrales, las listas de palabras y los clasificadores son configurables, y el alemán fue el primer idioma añadido después del inglés. Un filtro de longitud de palabra calibrado con el inglés, donde Gopher fijó límites de 3 a 10 caracteres, descarta buen alemán: la prosa oficial alemana promedia 11,7 caracteres por palabra frente a 5,7 de su traducción al inglés. El intervalo recomendado por FineWeb2 para el alemán, de 0 a 15, reduce la tasa de rechazo del 0,3% al 0,02%, lo que en unos 100 millones de documentos por rastreo significa que se conservan unos 300.000 documentos corrientes en lugar de descartarlos.
El filtro de palabras vacías es más drástico. Aplicado con la lista Gopher en inglés, descarta más del 87% de los documentos alemanes que lo alcanzan, frente al 0,6% con la lista en alemán, es decir, unas 150 veces más.
El cumplimiento normativo atraviesa las mismas etapas. Aleph Alpha filtra las URL contra la lista de vigilancia de falsificaciones y piratería de la Comisión Europea y la lista negra UT1 que mantiene la Université Toulouse Capitole, y sustituye la información de identificación personal, incluidos correos electrónicos, números de teléfono, direcciones IP y números de cuentas bancarias, por tokens especiales. Las formas ofuscadas como 'nombre [arroba] dominio' también cuentan. El coste está medido: en sus propios benchmarks de PII el modelo obtiene unos 5 puntos porcentuales menos que uno entrenado con los mismos datos sin sustitución de PII, mientras que los demás benchmarks se mantienen.
La factura de todo modelo que no sea en inglés
El caso alemán se lee menos como el anuncio de un producto que como una estimación de costes para todos los idiomas que no son el inglés. Aleph Alpha afirma haber curado y generado hasta ahora más de 2 billones de tokens alemanes de alta calidad, cerrando buena parte de la brecha entre lo que ofrece la web abierta y lo que necesita un modelo frontera. Que el próximo idioma salga más barato depende menos de mejores modelos sintéticos que de cuánto texto orgánico alberga la web de ese idioma.
- Fuente : Aleph Alpha needed 4 trillion German tokens. The open web offers 1.94. — 2026-09-08
Lo esencial de la tecnología en 3 minutos cada mañana
Un correo, cada día laborable, con lo que realmente importa en IA y tecnología.