Investigación en IA: artículo de arXiv, 3 de septiembre de 2026
Una sola consulta de entrenamiento cubre el 71,5% de lo que logra un conjunto de datos completo de destilación de LLM
Un nuevo artículo de arXiv concluye que una sola consulta de entrenamiento alcanza el 71,5% de la cobertura de estados que logra un conjunto de datos completo de destilación, y que 16 consultas diversas igualan el entrenamiento con datos completos. El cuello de botella, sostiene el artículo, es la rapidez con que un estudiante absorbe la supervisión.
Emmanuel Fabrice Omgbwa Yasse Asistido por IA
2026-09-17 · 4 min de lectura
Entrena una ejecución de destilación on-policy con una sola consulta y seguirá mejorando durante cientos de pasos. Un artículo enviado a arXiv el 3 de septiembre de 2026 informa de que este único ejemplo recupera la mayor parte de la ganancia que produce un conjunto de datos completo, en distintos dominios de tareas y familias de modelos.
La destilación on-policy (OPD) empareja las propias trayectorias (rollouts) de un modelo estudiante con supervisión densa a nivel de token procedente de un profesor. Trabajos anteriores de la serie se centraron en cómo se comporta el algoritmo y dejaron abierto el papel de los datos de entrenamiento. Este artículo lleva la cuestión de los datos a su mínimo entrenando con una sola consulta y observando qué hace el estudiante.
Una consulta, la mayor parte de la ganancia
La cifra principal no es una fracción pequeña de la ejecución con datos completos. La OPD con una única consulta sigue mejorando durante cientos de pasos y cierra la mayor parte de la brecha con el entrenamiento sobre todo lo que el artículo probó. Leído puramente como un resultado de eficiencia, eso hace que la destilación parezca barata. Leído como el artículo lo enmarca, plantea una pregunta más difícil sobre qué hacían realmente los datos adicionales.
Qué mide la cobertura de estados
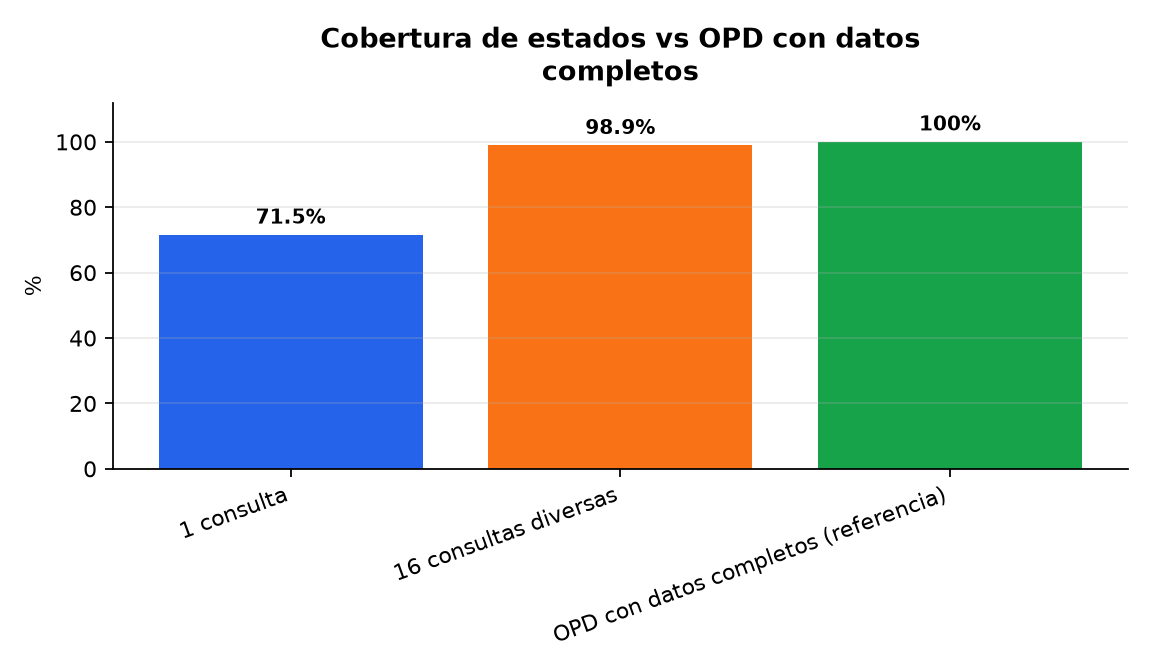
Para explicar el resultado, el artículo examina los estados que visita el estudiante durante el entrenamiento y define la cobertura de estados como la fracción de los estados que alcanza una ejecución de OPD con datos completos y que también alcanzan las trayectorias de un conjunto de consultas dado. Una sola consulta ya cubre el 71,5% de ellos, y la mayor parte de esa cobertura llega en los primeros 100 pasos.
El crecimiento posterior proviene de la diversidad, no del volumen. Añadir consultas semánticamente distintas eleva a la vez la cobertura y la precisión de validación, hasta que 16 consultas alcanzan el 98,9% e igualan el entrenamiento con datos completos.
| Conjunto de entrenamiento | Cobertura de estados | Resultado reportado |
|---|---|---|
| Consulta única | 71,5% | La mayor parte de la cobertura se alcanza en los primeros 100 pasos |
| 16 consultas semánticamente distintas | 98,9% | Iguala la OPD con datos completos |
| 16 consultas diversas por dominio (OPD multi-profesor) | No reportado | Iguala el entrenamiento multi-profesor con datos completos |
El estudiante absorbe más despacio de lo que llegan los datos
Si una sola consulta aporta casi toda la cobertura, ¿por qué el entrenamiento con una única consulta sigue necesitando cientos de pasos para mejorar? La respuesta del artículo es que la alineación entre estudiante y profesor se ralentiza a un ritmo aproximadamente igual tanto si la OPD entrena con una consulta como si entrena con todo el conjunto de datos. Incluso un conjunto fijo de estados, entregado y ya sin cambios, tarda cientos de pasos en absorberse.
Ese desajuste produce el diagnóstico tajante del artículo: la OPD está "sobrealimentada de datos pero hambrienta de algoritmo". Sus trayectorias exponen una supervisión amplia con rapidez, mientras el estudiante absorbe esa supervisión a un ritmo decreciente.
Las plantillas y los prompts fuera de dominio se acercan
Dos pruebas de estrés cuestionan la idea de que el contenido de la consulta sea el ingrediente activo. Las plantillas con poco contenido, que aportan poca sustancia de la tarea, se acercan a la línea base de las consultas reales. Lo mismo ocurre con consultas fuera de dominio de WildChat. El artículo concluye que el contenido de la tarea y la cobertura de estados inducida pueden separarse, lo que significaría que un conjunto de consultas puede estar casi vacío de la tarea y aun así acercar al estudiante a los estados que importan.
Lo que el listado no resuelve
No nombra dominios de tareas ni familias de modelos, y no reporta replicación independiente. Además, la cobertura se mide contra una única referencia, los estados que visita la OPD con datos completos, por lo que la métrica describe cuánto territorio de esa ejecución alcanza una ejecución más pequeña, en lugar de ser una medida absoluta de cuánta supervisión es suficiente.
El mismo patrón se extiende a la OPD multi-profesor, donde 16 consultas semánticamente diversas por dominio igualan el entrenamiento con datos completos. La esperanza declarada del artículo es que estos resultados reorienten el trabajo hacia la eficiencia en pasos del método y propicien una nueva mirada a los datos y a los mecanismos detrás de sus recientes éxitos en el post-entrenamiento de frontera.
Reducir un conjunto de entrenamiento a 16 consultas e igualar la línea base es un resultado extraño para una técnica cuyos recientes éxitos en la frontera el artículo atribuye en parte a los datos. Su lectura es que más datos cambian la rapidez con que llega la supervisión, no cuánta puede asimilar un estudiante. Si eso se sostiene, la próxima ronda de mejoras pertenece al bucle de entrenamiento, no al corpus.
- Fuente : One training query covers 71.5% of what a full LLM distillation dataset does — 2026-09-03
Lo esencial de la tecnología en 3 minutos cada mañana
Un correo, cada día laborable, con lo que realmente importa en IA y tecnología.