Automatización de la investigación en IA, arXiv, septiembre de 2026
DisCo reporta una mejora del 134,3 % en MLE-bench con su backbone fijo
DisCo destila 1.000 repositorios de ML en más de 5.000 skills reutilizables y reporta grandes ganancias en benchmarks con el modelo, el harness y el presupuesto de ejecución fijos. Las cifras son autoinformadas y no han sido replicadas.
Emmanuel Fabrice Omgbwa Yasse Asistido por IA
2026-09-16 · 4 min de lectura
El número que viajará desde un nuevo preprint de arXiv es 134,3 %. Un agente de investigación llamado DisCo, al que se le entrega una biblioteca de "skills" destiladas, obtiene una puntuación esa cantidad superior en MLE-bench respecto del mismo agente sin ellas, según los autores del artículo. El resto del resumen es arquitectura, y las cifras solo tienen sentido dentro de ella.
La afirmación se sostiene en lo que no cambió
El preprint, titulado Repo-To-Skill: Distilling GitHub Repositories Into AI4AI Skills, reporta que DisCo tanto crea skills como las usa durante la investigación. Describe dos rutas de destilación. La destilación agnóstica a la tarea condensa repositorios ampliamente utilizados en skills reutilizables; la destilación orientada a la tarea produce las skills que requiere una tarea específica. Ejecutada sobre el ecosistema abierto, la primera ruta produce la AREX-Skill Library: más de 5.000 skills verificadas destiladas de 1.000 repositorios de machine learning ampliamente utilizados, organizadas en 20 áreas y 178 familias de capacidades.
Esa biblioteca es solo la mitad de la afirmación. Las ganancias reportadas se dan con el backbone GPT-5.5, el harness de investigación y el presupuesto de ejecución posterior fijos. Esa frase sostiene el argumento del artículo. Si nada más cambió excepto el contexto inyectado, el delta corresponde a las skills y no a un modelo más grande o a una ejecución más larga. Los autores lo dicen sin rodeos: las ganancias provienen de añadir contexto operativo destilado bajo esa configuración fija.
La capa ausente que el artículo llama conocimiento operativo
La tesis central del artículo trata de lo que un agente no tiene. No afirma tener un mejor planificador ni un mejor módulo de memoria. Sostiene que el know-how que separa conocer un método de hacerlo funcionar reside fuera del agente por completo, en una capa que los autores llaman conocimiento operativo. Una arquitectura de agente, según su descripción, combina un backbone de modelo con un harness para planificación, ejecución, memoria y verificación. El conocimiento operativo es lo que al harness todavía le falta.
Ese conocimiento no falta en el campo, según el preprint. Aparece en repositorios y artículos, escritos para lectores humanos y demasiado extensos para cargarlos durante una sola tarea. La destilación es la solución: reducirlo a skills compactas y verificadas que se reutilizan entre tareas en lugar de redescubrirse en cada ejecución.
Cuatro benchmarks, ninguna línea base compartida
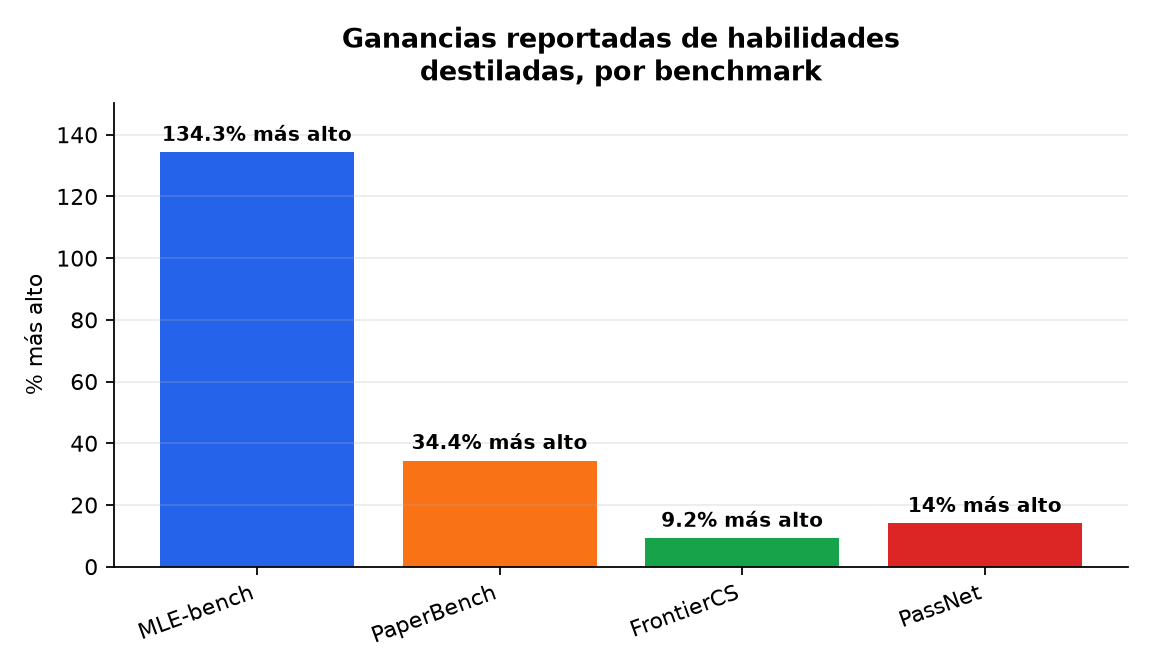
El resumen reporta cuatro ganancias, y van de grandes a modestas.
| Benchmark | Ganancia reportada, con skills vs. sin skills |
|---|---|
| MLE-bench | 134,3 % superior |
| PaperBench | 34,4 % superior |
| FrontierCS | 9,2 % superior |
| PassNet | 14,0 % superior |
El resumen no describe qué mide cada benchmark, cuáles eran las puntuaciones de la línea base ni cómo se calculó cada porcentaje, por lo que las cuatro cifras no pueden leerse unas contra otras. Un delta grande en una prueba no se traslada a uno pequeño en otra, y la dispersión que aparece aquí puede reflejar las tareas, la puntuación o ambas cosas. Tampoco ofrece el resumen puntuaciones absolutas, que es el dato que mostraría si una mejora del 134,3 % se apoya en una línea base débil.
Un preprint, no un resultado replicado
Se trata de un único envío, catalogado bajo ciencias de la computación e inteligencia artificial y publicado en arXiv el 2 de septiembre de 2026. El material disponible no contiene registro de revisión por pares, y ningún grupo independiente ha reproducido las cifras. Las mediciones son de los propios autores, tomadas en su propio sistema y bajo su propio harness. Eso no las hace erróneas. Las convierte en una afirmación por comprobar en lugar de un resultado para citar.
El detalle que hay que vigilar cuando alguien intente reproducir esto no es el 134,3 %. Es si una biblioteca de skills congelada se transfiere a un backbone diferente. El experimento reportado aquí mantiene el backbone fijo, lo que es una forma limpia de aislar el efecto del contexto, pero no puede mostrar por sí solo que el contexto viaje.
Si las skills se consolidan como una capa arquitectónica
El preprint sitúa las skills junto al backbone y al harness como un tercer lugar donde almacenar know-how, uno que ni los pesos ni el andamiaje cubren actualmente. Si esa posición se sostiene es una pregunta que el resumen deja abierta. No nombra sistemas competidores y no dice si otros esfuerzos de automatización de la investigación trabajan en la misma capa o devuelven el problema al interior del modelo.
Lo que sí ofrece es una forma comprobable. Si el conocimiento operativo puede destilarse, verificarse y reutilizarse, entonces parte de lo que hace funcionar a un agente de investigación es un problema de biblioteca y no de entrenamiento. Mil repositorios y 5.000 skills es un único punto de datos para esa idea, publicado por las personas que construyeron la biblioteca.
El 134,3 % es el anuncio. Las variables mantenidas fijas son la parte que quien replique puede comprobar de verdad.
- Fuente : DisCo reports a 134.3% MLE-bench gain with its backbone held fixed — 2026-09-02
Lo esencial de la tecnología en 3 minutos cada mañana
Un correo, cada día laborable, con lo que realmente importa en IA y tecnología.