Automatisation de la recherche en IA, arXiv, septembre 2026
DisCo annonce un gain de 134,3 % sur MLE-bench, backbone maintenu fixe
DisCo distille 1 000 dépôts de ML en plus de 5 000 compétences réutilisables et rapporte d'importants gains sur les benchmarks, à modèle, harness et budget d'exécution maintenus fixes. Les chiffres sont auto-déclarés et non répliqués.
Emmanuel Fabrice Omgbwa Yasse Assisté par IA
2026-09-16 · 4 min de lecture
Le chiffre qui va circuler depuis une nouvelle prépublication arXiv est 134,3 %. Un agent de recherche baptisé DisCo, doté d'une bibliothèque de « compétences » distillées, obtient sur MLE-bench un score supérieur de ce pourcentage à celui du même agent sans elles, selon les auteurs de l'article. Le reste du résumé est de l'architecture, et les chiffres n'ont de sens qu'à l'intérieur de celle-ci.
L'affirmation repose sur ce qui n'a pas changé
La prépublication, intitulée Repo-To-Skill: Distilling GitHub Repositories Into AI4AI Skills, indique que DisCo crée les compétences et les utilise pendant la recherche. Elle décrit deux voies de distillation. La distillation indépendante de la tâche condense des dépôts largement utilisés en compétences réutilisables ; la distillation orientée tâche produit les compétences qu'une tâche spécifique requiert. Appliquée à l'écosystème ouvert, la première voie produit l'AREX-Skill Library : plus de 5 000 compétences vérifiées distillées à partir de 1 000 dépôts d'apprentissage automatique largement utilisés, organisées en 20 domaines et 178 familles de capacités.
Cette bibliothèque ne représente que la moitié de l'affirmation. Les gains rapportés s'accompagnent d'un backbone GPT-5.5, d'un harness de recherche et d'un budget d'exécution en aval tous maintenus fixes. C'est cette phrase qui porte l'argument de l'article. Si rien d'autre n'a changé hormis le contexte injecté, le delta revient aux compétences plutôt qu'à un modèle plus grand ou à une exécution plus longue. Les auteurs le formulent sans détour : les gains proviennent de l'ajout d'un contexte opérationnel distillé dans cette configuration fixe.
La couche manquante que l'article appelle connaissance opérationnelle
La thèse centrale de l'article porte sur ce qu'un agent n'a pas. Il ne revendique ni un meilleur planificateur ni un meilleur module de mémoire. Il soutient que le savoir-faire qui sépare la connaissance d'une méthode de sa mise en œuvre se situe entièrement en dehors de l'agent, dans une couche que les auteurs appellent connaissance opérationnelle. Une architecture d'agent, selon leur description, combine un backbone de modèle avec un harness pour la planification, l'exécution, la mémoire et la vérification. La connaissance opérationnelle est ce qui manque encore au harness.
Cette connaissance ne manque pas au domaine, selon la prépublication. Elle apparaît dans des dépôts et des articles, rédigée pour des lecteurs humains et trop volumineuse pour être chargée au cours d'une seule tâche. La distillation est la solution : la réduire en compétences compactes et vérifiées, réutilisées d'une tâche à l'autre au lieu d'être redécouvertes à chaque exécution.
Quatre benchmarks, aucune référence commune
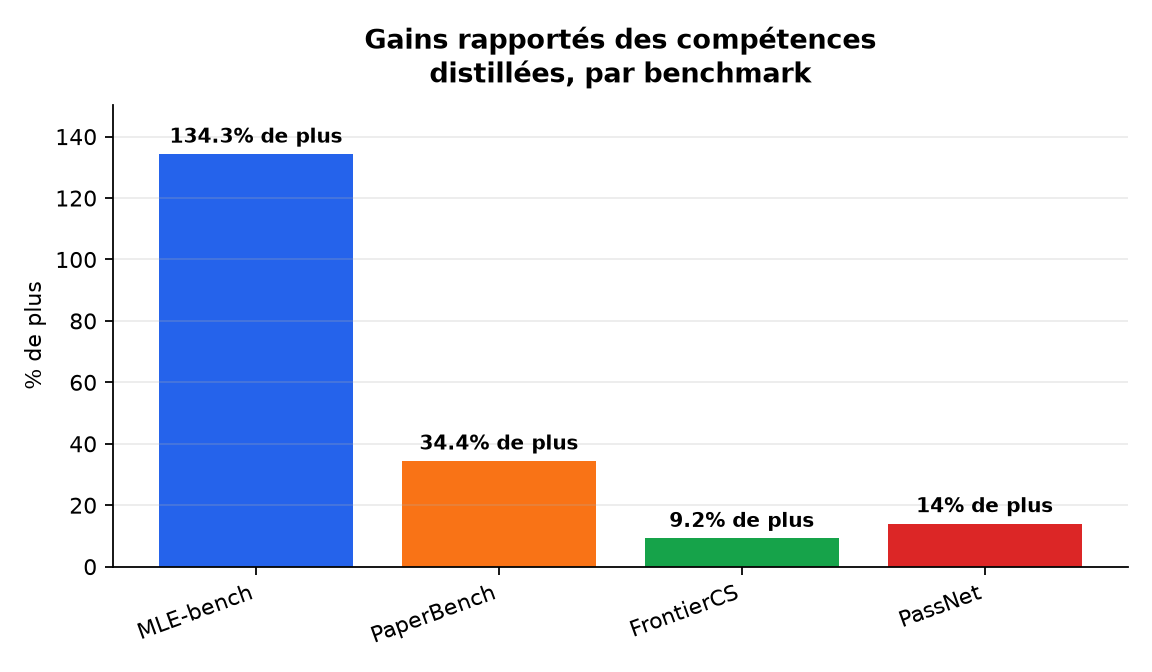
Le résumé rapporte quatre gains, qui vont d'important à modeste.
| Benchmark | Gain rapporté, avec compétences vs sans |
|---|---|
| MLE-bench | 134,3 % de plus |
| PaperBench | 34,4 % de plus |
| FrontierCS | 9,2 % de plus |
| PassNet | 14,0 % de plus |
Le résumé ne décrit pas ce que mesure chaque benchmark, quels étaient les scores de référence, ni comment chaque pourcentage a été calculé ; les quatre chiffres ne peuvent donc pas être lus les uns par rapport aux autres. Un écart important sur un test ne se transpose pas à un écart faible sur un autre, et la dispersion observée ici peut refléter les tâches, la notation, ou les deux. Le résumé ne donne pas non plus de scores absolus, le détail qui montrerait si une amélioration de 134,3 % repose sur une référence faible.
Une prépublication, pas un résultat répliqué
Il s'agit d'une soumission unique, classée en informatique et intelligence artificielle et publiée sur arXiv le 2 septembre 2026. Le matériel disponible ne comporte aucune trace d'évaluation par les pairs, et aucun groupe indépendant n'a reproduit les chiffres. Les mesures sont celles des auteurs, prises sur leur propre système avec leur propre harness. Cela ne les rend pas fausses. Cela en fait une affirmation à tester plutôt qu'un résultat à citer.
Le détail à surveiller lorsque quelqu'un tentera de reproduire ce travail n'est pas le 134,3 %. C'est de savoir si une bibliothèque de compétences figée se transfère à un autre backbone. L'expérience rapportée ici maintient le backbone fixe, ce qui est une manière propre d'isoler l'effet du contexte, mais ne peut à elle seule démontrer que le contexte voyage.
Les compétences s'imposeront-elles comme couche architecturale
La prépublication place les compétences aux côtés du backbone et du harness comme troisième lieu de stockage du savoir-faire, un lieu que ni les poids ni l'échafaudage ne couvrent actuellement. Que cette position tienne est une question que le résumé laisse ouverte. Il ne nomme aucun système concurrent et ne dit pas si d'autres efforts d'automatisation de la recherche travaillent sur la même couche ou renvoient le problème à l'intérieur du modèle.
Ce qu'il offre, en revanche, est une forme testable. Si la connaissance opérationnelle peut être distillée, vérifiée et réutilisée, alors une partie de ce qui fait fonctionner un agent de recherche relève d'un problème de bibliothèque plutôt que d'entraînement. Mille dépôts et 5 000 compétences constituent un seul point de données pour cette idée, publié par ceux qui ont construit la bibliothèque.
134,3 % est l'argument publicitaire. Les variables maintenues fixes sont la partie qu'un réplicateur peut réellement vérifier.
- Source : DisCo reports a 134.3% MLE-bench gain with its backbone held fixed — 2026-09-02
L'essentiel de la tech en 3 minutes chaque matin
Un email, chaque jour ouvré, avec ce qui compte vraiment en IA et en tech.