IA explicable: investigación sobre previsión energética
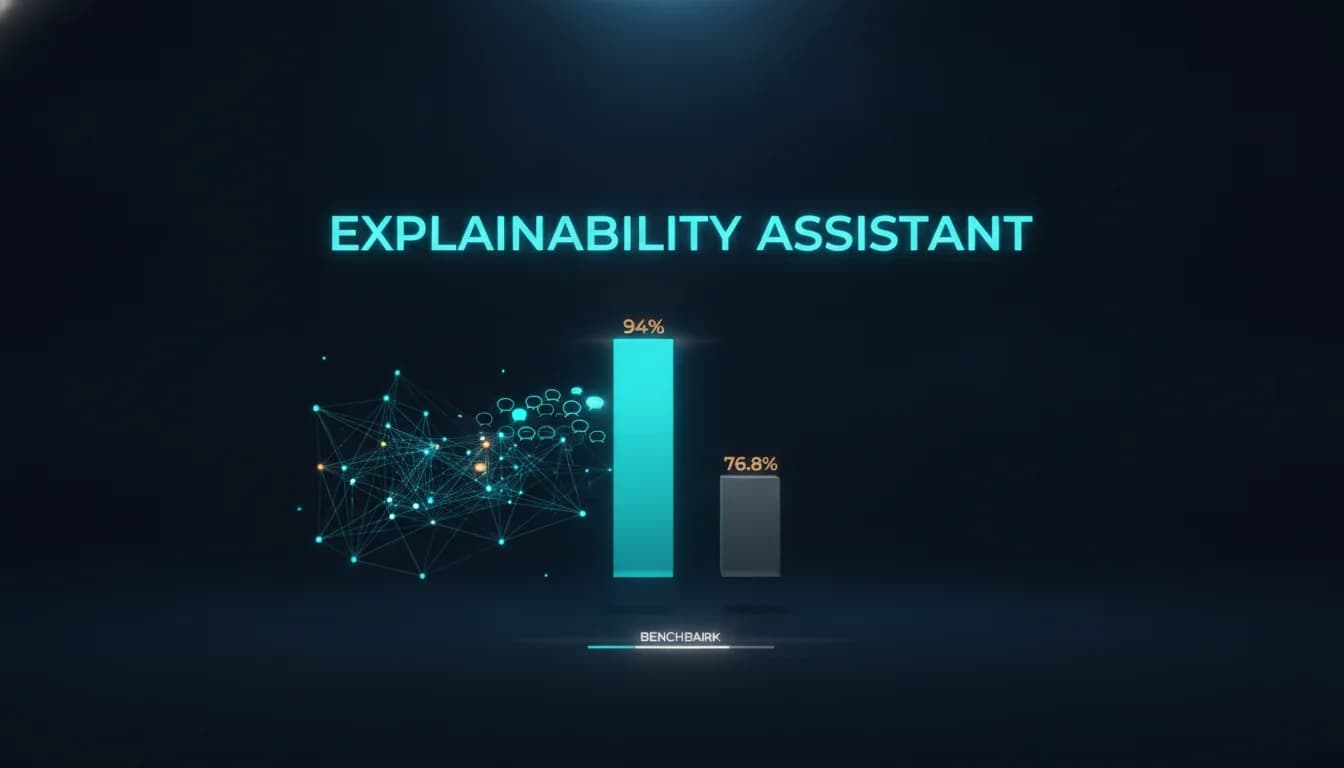
Explainability Assistant interpreta el 94% de las consultas, superando el 76.8% de TalkToModel
La precisión en la interpretación de intenciones en la XAI conversacional asciende al 94% desde el 76.8% de TalkToModel, y los especialistas prefirieron por unanimidad el nuevo sistema frente a un panel convencional. Lo que la evaluación no mide es si los operadores toman mejores decisiones.
Emmanuel Fabrice Omgbwa Yasse Asistido por IA
2026-09-20 · 4 min de lectura
Quienes gestionan edificios rara vez pueden hacerle una pregunta a sus modelos de previsión. Reciben un panel: un gráfico de importancia de variables, una fila de controles diseñados para alguien que ya sabe qué botón girar. Para un responsable de instalaciones que intenta averiguar por qué la previsión de carga del martes salió alta, ese gráfico no es una explicación.
Un artículo enviado a arXiv el 10 de septiembre de 2026 sostiene que el problema ha sido la propia interfaz y que la solución llegó de un lugar inesperado. El Explainability Assistant, que los autores describen como de código abierto, permite a los operadores interrogar en lenguaje corriente a un modelo de consumo energético. Reporta una precisión de interpretación de intenciones del 94%, frente al 76.8% de TalkToModel, un sistema anterior de XAI conversacional limitado por gramáticas escritas a mano.
La diferencia de diecisiete puntos no es lo interesante. Lo que importa es por qué existe: TalkToModel reconocía un conjunto fijo de formulaciones, mientras que el Explainability Assistant encamina las preguntas a través de las capacidades de llamada a funciones de los grandes modelos de lenguaje modernos. Según el artículo, eso permite al sistema admitir lenguaje natural flexible y adaptarse a distintos tipos de problemas de ML sin un ajuste fino específico para cada tarea.
Las gramáticas escritas a mano eran el cuello de botella
Una gramática personalizada es una apuesta a que se puede predecir cómo formulará la gente una pregunta. Se escriben patrones para la palabra por qué, para preguntas hipotéticas, para solicitudes de explicar una predicción concreta, y luego un operador pregunta algo que los patrones nunca previeron. La gramática falla. El operador reformula, con una variación mínima. La interfaz parece rota aunque el modelo que hay detrás funcione correctamente.
La llamada a funciones esquiva ese problema al dejar que el modelo decida a qué herramienta corresponde una pregunta, en lugar de cotejarla con una lista. El artículo lo trata como la decisión arquitectónica central, y la brecha del 76.8% al 94% es la evidencia que la respalda. Esos diecisiete puntos separan a un sistema que entiende la mayor parte de lo que se le pregunta de otro que entiende casi todo.
Hay una segunda afirmación en el resumen que merece desglosarse. Como la interfaz no está ajustada para una tarea específica, el artículo sostiene que se adapta a distintos tipos de problemas de ML. Una sola capa conversacional podría colocarse delante de un regresor simbólico basado en programación genética u otro modelo sin necesidad de reconstruirla. La evaluación se sitúa en el ámbito energético, pero el argumento arquitectónico no depende de ello.
Lo que el número del titular no abarca
| Sistema | Cómo gestiona una pregunta | Precisión de interpretación de intenciones |
|---|---|---|
| TalkToModel | Gramática personalizada rígida | 76.8% |
| Explainability Assistant | Llamada a funciones de LLM | 94% |
Al leer esa tabla, parece una victoria limpia, que es más o menos como la presenta el resumen. La precisión de interpretación de intenciones mide si el sistema averiguó qué quería el usuario. No dice nada sobre si la explicación que siguió era correcta, completa o útil para quien la leía.
El artículo sí reporta una evaluación comparativa realizada con especialistas del ámbito energético, que contrasta el asistente con un panel de XAI tradicional. Los resultados se describen como una mejor usabilidad y una precisión de tarea constante, y todos los expertos prefirieron la interfaz conversacional para un uso práctico.
La preferencia unánime es una señal real, y a la vez poco especificada. El material disponible no dice cuántos especialistas participaron, cuántas tareas completó cada uno, ni si la precisión de tarea se puntuó con una rúbrica fija. En los estudios de interfaces, la preferencia tiende a favorecer lo que parece más rápido y con mayor capacidad de respuesta, algo que un chatbot suele ofrecer. Si los operadores llegaron a mejores conclusiones es una medición distinta, y una que el resumen no reporta.
La dependencia que el artículo no aborda
Una capa de explicación construida sobre la llamada a funciones hereda las propiedades del modelo que tiene debajo. Cada pregunta conlleva un coste por consulta y algo de latencia, y quien aloja ese modelo puede actualizarlo o retirarlo sin preguntar a nadie. Los autores llaman al sistema de código abierto, pero el material proporcionado no especifica a qué modelo llama ni si ese modelo se ejecuta localmente o mediante una API alojada. Para un equipo de instalaciones de un campus o una empresa de servicios públicos que decida si ponerlo delante de su personal, ese detalle probablemente decida el despliegue.
Hacia dónde debe ir la próxima evaluación
La contribución aquí es más estrecha que un chatbot que explica una previsión, y más útil de lo que parece. Ahora puede ensamblarse una capa de XAI conversacional sin un analizador sintáctico a medida, lo que elimina uno de los principales costes de ingeniería que mantenían estas interfaces fuera del software de gestión de instalaciones. Ese coste solía significar contratar a un equipo para escribir y mantener una gramática. Ahora significa conectar un modelo de llamada a funciones.
Lo que no se ha vuelto más fácil es la parte posterior al análisis. Un operador que pregunta por qué un modelo predijo un consumo alto quiere una respuesta sobre la que pueda actuar: cambiar un horario o revisar un sensor. Reconocer correctamente la pregunta es un requisito previo para eso, no un sustituto. Si la explicación que está al otro lado cambia lo que el operador hace después es la pregunta que este artículo plantea y deja abierta.
- Fuente : Explainability Assistant parses 94% of queries, beating TalkToModel's 76.8% — 2026-09-10
Lo esencial de la tecnología en 3 minutos cada mañana
Un correo, cada día laborable, con lo que realmente importa en IA y tecnología.