IA souveraine · Les modèles linguistiques allemands
Aleph Alpha avait besoin de 4 billions de tokens allemands. Le web ouvert en offre 1,94.
Les travaux d'ablation d'Aleph Alpha fixent un seuil de 4 billions de tokens pour le pré-entraînement en allemand. Les six plus grands jeux de données allemands gratuits totalisent environ 1,94 billion, dont près de 600 milliards issus de traduction automatique de l'anglais.
Emmanuel Fabrice Omgbwa Yasse Assisté par IA
2026-09-17 · 5 min de lecture
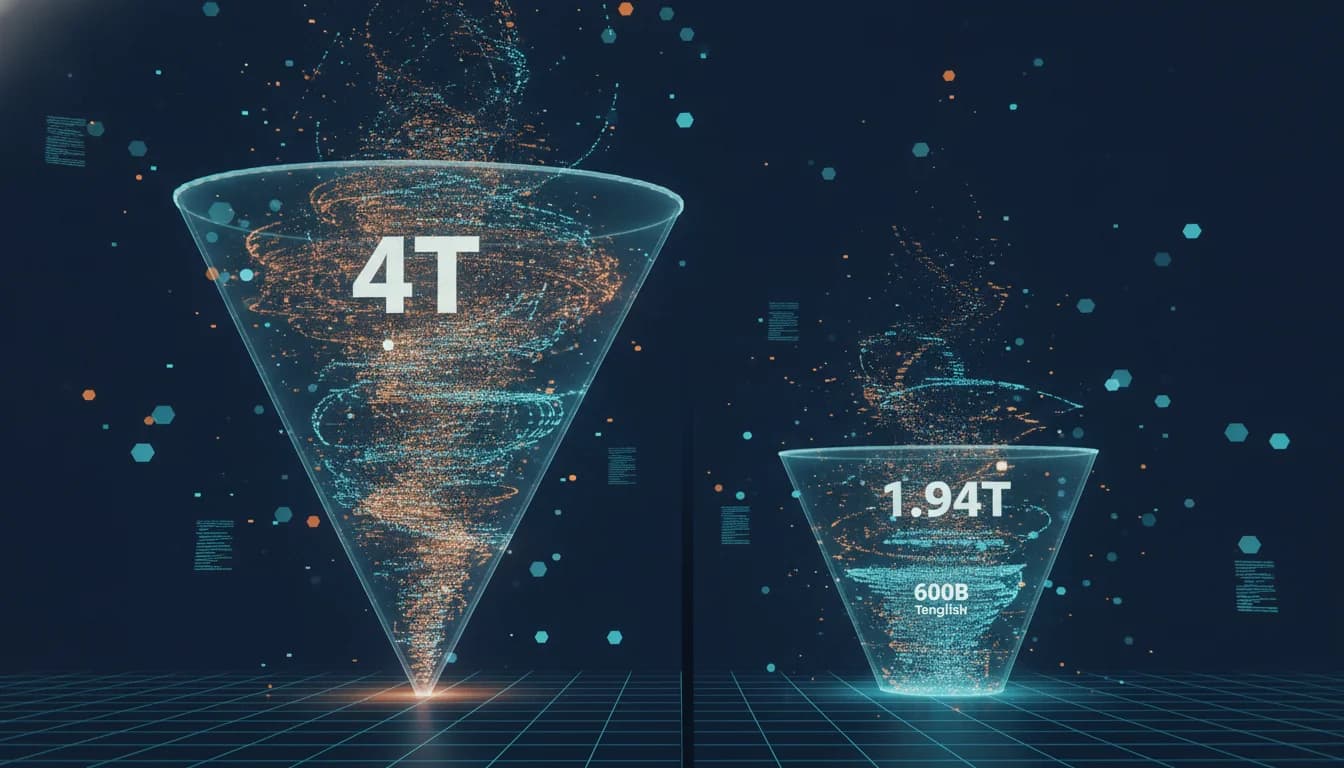
Un modèle de langue frontière est surtout un problème de données avant d'être un problème de modélisation, et pour l'allemand, ce problème de données a un chiffre. Aleph Alpha affirme qu'une campagne d'entraînement en langue allemande nécessite au moins 4 billions de tokens allemands, un seuil que ses études d'ablation établissent en montrant qu'une part de 20 % d'allemand donne les meilleurs résultats sur ses benchmarks allemands. Le web ouvert, tel qu'il est actuellement constitué, n'en offre qu'environ la moitié.
Six jeux de données gratuits constituent l'essentiel de ce qu'un concepteur de modèle allemand peut trouver prêt à l'emploi.
| Jeu de données | Taille (milliards de tokens) | Dernières données sources |
|---|---|---|
| HPLT 3.0 (part allemande) | 609 | 2025 |
| KletterMix (traduction automatique de ClimbMix) | 500 | 2024 |
| FineWeb2 (part allemande) | 378 | 2024 |
| FinePDFs (part allemande) | 177 | 2025 |
| German Commons | 154 | 2025 |
| MT-Nemotron-CC (traduction automatique de Nemotron-CC) | 117 | 2024 |
Ensemble, ils totalisent environ 1,94 billion de tokens, un chiffre qu'Aleph Alpha obtient en divisant par quatre la taille en octets non compressés de chaque jeu de données afin que les décomptes soient comparables. Entraîner un modèle de pointe nécessite aujourd'hui plus de 20 billions de tokens, selon les calculs de l'entreprise, qui cite Nemotron 3 Super. Elle s'appuie aussi sur Muennighoff et al. à propos de la répétition : réutiliser les mêmes documents cesse d'être rentable au-delà d'environ quatre époques, si bien que la cible allemande peut puiser dans un corpus plus petit, mais pas arbitrairement petit.
Un plafond, pas un total
Deux contraintes abaissent ce chiffre de 1,94 billion. La première est la provenance : environ 600 milliards, répartis entre KletterMix et MT-Nemotron-CC, proviennent de la traduction automatique de corpus anglais plutôt que de textes natifs allemands. La seconde est le chevauchement : HPLT 3.0, FineWeb2 et German Commons dérivent tous de Common Crawl, si bien que leurs tailles ne s'additionnent pas simplement une fois les doublons supprimés.
Il y a ensuite la fraîcheur. Chaque jeu de données gratuit est un instantané, assemblé à partir de crawls jusqu'à une date fixe, puis gelé ; FineWeb2 ne contient rien de crawl après avril 2024. L'exemple de défaillance donné par Aleph Alpha est sans détour. Entraîné sans recherche documentaire ni accès à des outils, un modèle construit sur ces données répondra avec assurance qu'Olaf Scholz est chancelier. Les versions plus récentes rapprochent la date limite du présent, mais de quelques mois seulement, et uniquement lorsque l'éditeur publie une nouvelle version.
L'entreprise a construit son propre pipeline Common Crawl autour de ce rythme. Il est incrémental, de sorte qu'un nouvel instantané peut être intégré sans retraiter ce qui précède, et il est paramétré par langue. Plus de 120 instantanés existent et environ un arrive chaque mois, chacun contenant près de 100 millions de documents allemands, soit environ 50 milliards de tokens bruts. La déduplication et les heuristiques réduisent fortement ce volume, et Aleph Alpha énonce clairement le compromis : chaque étape de filtrage achète de la qualité au prix de la quantité.
Les données synthétiques multiplient, elles n'ajoutent pas
Aleph Alpha utilise des données synthétiques tout en les traitant comme un rôle de second plan. La reformulation, où un LLM réécrit des documents allemands existants en entrées encyclopédiques, dialogues questions-réponses ou passages de manuels, a produit environ 1 milliard de tokens pour son jeu de données Aleph-Alpha-GermanWeb, issu du texte allemand de FineWeb2. La méthode est peu coûteuse de la bonne manière : le modèle a besoin d'un bon allemand, pas d'une connaissance approfondie du monde germanophone, et il habille les mêmes faits de nombreuses formulations. Elle ne peut pas créer de connaissances qui n'existaient pas déjà.
La traduction constitue l'autre moitié, et elle importe un biais. L'allemand issu de traduction automatique est généralement grammatical, mais glisse vers ce que l'entreprise appelle le translationese, la manie de rendre les idiomes mot à mot : 'Drive safe!' devient 'Fahre sicher!' plutôt que l'idiomatique 'Komm gut an!' Le problème plus profond est la distribution. Un corpus traduit de l'anglais porte le penchant géographique et institutionnel du web anglais, si bien qu'un modèle entraîné principalement sur lui apprend à parler allemand d'un monde qui ressemble à l'Amérique. Pleias et NVIDIA fondent leurs jeux de données Nemotron-Personas sur les statistiques de recensement national pour la même raison, note Aleph Alpha.
L'argument contraire a droit à une audition. Les auteurs d'ÜberWeb soutiennent que les connaissances se transfèrent bien d'une langue à l'autre. Mais Aleph Alpha cite à la fois ÜberWeb et des travaux plus récents de Gaber et al. qui suggèrent qu'un bon transfert exige une curation multilingue soignée, et éventuellement une traduction ciblée, afin d'éviter de nuire aux performances par langue. Aucune des deux approches ne remplace les données web allemandes organiques, car toutes deux les présupposent.
Un filtre mal réglé, sept documents perdus sur huit
Le pipeline est l'élément le plus transférable. Les seuils, listes de mots et classificateurs sont configurables, et l'allemand a été la première langue ajoutée après l'anglais. Un filtre de longueur des mots calibré sur l'anglais, où Gopher fixe des bornes de 3 à 10 caractères, écarte du bon allemand : la prose administrative allemande compte en moyenne 11,7 caractères par mot, contre 5,7 pour sa traduction anglaise. L'intervalle allemand recommandé par FineWeb2, de 0 à 15, ramène le taux de rejet de 0,3 % à 0,02 %, ce qui, sur environ 100 millions de documents par crawl, signifie qu'environ 300 000 documents ordinaires sont conservés au lieu d'être écartés.
Le filtre de mots vides est plus frappant encore. Appliqué avec la liste Gopher anglaise, il écarte plus de 87 % des documents allemands qui l'atteignent, contre 0,6 % avec la liste allemande, soit environ 150 fois plus.
La conformité passe par les mêmes étapes. Aleph Alpha filtre les URL par rapport à la liste de surveillance des contrefaçons et de la piraterie de la Commission européenne et à la liste noire UT1 maintenue par l'Université Toulouse Capitole, et remplace les informations personnellement identifiables, courriels, numéros de téléphone, adresses IP et numéros de compte bancaire, par des tokens spéciaux. Les formes obfusquées comme 'name [at] domain' comptent aussi. Le coût est mesuré : sur ses propres benchmarks de données personnelles, le modèle obtient environ 5 points de pourcentage de moins qu'un modèle entraîné sur les mêmes données sans remplacement des données personnelles, tandis que les autres benchmarks tiennent.
L'addition pour tout modèle non anglophone
Le cas allemand se lit moins comme l'annonce d'un produit que comme une estimation de coût pour toute langue qui n'est pas l'anglais. Aleph Alpha affirme avoir, à ce jour, curé et généré plus de 2 billions de tokens allemands de haute qualité, comblant une grande partie de l'écart entre ce que le web ouvert offre et ce dont un modèle frontière a besoin. Savoir si la prochaine langue coûtera moins cher dépend moins de meilleurs modèles synthétiques que de la quantité de texte organique que contient le web de cette langue.
- Source : Aleph Alpha needed 4 trillion German tokens. The open web offers 1.94. — 2026-09-08
L'essentiel de la tech en 3 minutes chaque matin
Un email, chaque jour ouvré, avec ce qui compte vraiment en IA et en tech.