Recherche en IA : article arXiv, 3 septembre 2026
Une seule requête d'entraînement couvre 71,5 % de ce que couvre un jeu de données complet de distillation de LLM
Un nouvel article arXiv constate qu'une seule requête d'entraînement atteint 71,5 % de la couverture d'états d'un jeu de données de distillation complet, et que 16 requêtes diversifiées égalent l'entraînement sur données complètes. Le goulot d'étranglement, soutient l'article, est la vitesse à laquelle un modèle étudiant absorbe la supervision.
Emmanuel Fabrice Omgbwa Yasse Assisté par IA
2026-09-17 · 4 min de lecture
Entraînez une exécution de distillation on-policy sur une seule requête et elle continuera de s'améliorer pendant des centaines d'étapes. Un article soumis à arXiv le 3 septembre 2026 rapporte que cet unique exemple récupère la majeure partie du gain produit par un jeu de données complet, à travers différents domaines de tâches et familles de modèles.
La distillation on-policy (OPD) associe les propres rollouts d'un modèle étudiant à une supervision dense, au niveau des tokens, fournie par un modèle enseignant. Des travaux antérieurs de la série se concentraient sur le comportement de l'algorithme, laissant ouverte la question du rôle des données d'entraînement. Cet article pousse la question des données à son minimum en entraînant sur une seule requête et en observant ce que fait le modèle étudiant.
Une seule requête, l'essentiel du gain
Le chiffre principal n'est pas une petite fraction de l'exécution sur données complètes. L'OPD one-shot continue de s'améliorer pendant des centaines d'étapes et comble la majeure partie de l'écart avec l'entraînement sur tout ce que l'article a testé. Lu purement comme un résultat d'efficacité, cela fait paraître la distillation peu coûteuse. Lu comme l'article le présente, cela soulève une question plus difficile : à quoi servaient donc les données supplémentaires.
Ce que mesure la couverture d'états
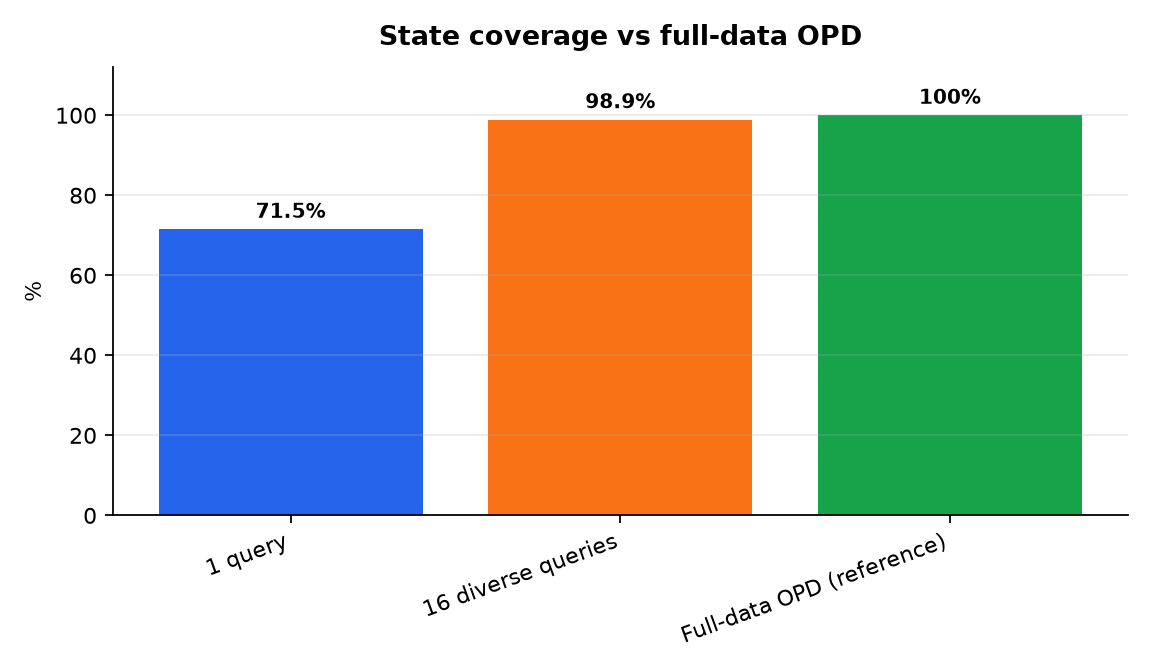
Pour expliquer ce résultat, l'article examine les états que le modèle étudiant visite pendant l'entraînement et définit la couverture d'états comme la fraction des états atteints par une exécution d'OPD sur données complètes que les rollouts d'un ensemble de requêtes donné atteignent aussi. Une seule requête en couvre déjà 71,5 %, et l'essentiel de cette couverture arrive dans les 100 premières étapes.
La croissance au-delà vient de la diversité, non du volume. L'ajout de requêtes sémantiquement distinctes augmente ensemble la couverture et la précision de validation, jusqu'à ce que 16 requêtes atteignent 98,9 % et égalent l'entraînement sur données complètes.
| Jeu d'entraînement | Couverture d'états | Résultat rapporté |
|---|---|---|
| Requête unique | 71,5 % | L'essentiel de la couverture atteint dans les 100 premières étapes |
| 16 requêtes sémantiquement distinctes | 98,9 % | Égale l'OPD sur données complètes |
| 16 requêtes diversifiées par domaine (OPD multi-enseignants) | Non rapporté | Égale l'entraînement multi-enseignants sur données complètes |
Le modèle étudiant absorbe plus lentement que les données n'arrivent
Si une seule requête fournit presque toute la couverture, pourquoi l'entraînement one-shot a-t-il encore besoin de centaines d'étapes pour s'améliorer ? La réponse de l'article est que l'alignement entre le modèle étudiant et le modèle enseignant ralentit à peu près au même rythme que l'OPD s'entraîne sur une seule requête ou sur l'ensemble du jeu de données. Même un ensemble fixe d'états, transmis et ne changeant plus, prend des centaines d'étapes à absorber.
Ce décalage produit le diagnostic sans détour de l'article : l'OPD est « suralimentée en données mais affamée d'algorithme ». Ses rollouts exposent rapidement une supervision large, tandis que le modèle étudiant absorbe cette supervision à un rythme décroissant.
Les gabarits et les prompts hors domaine s'en approchent
Deux tests de résistance vont à l'encontre de l'idée que le contenu de la requête est l'ingrédient actif. Des gabarits pauvres en contenu, qui portent peu de substance de tâche, s'approchent de la référence obtenue avec de vraies requêtes. Il en va de même pour les requêtes WildChat hors domaine. L'article conclut que le contenu de la tâche et la couverture d'états induite peuvent se dissocier, ce qui signifierait qu'un ensemble de requêtes peut être presque vide de la tâche et malgré tout rapprocher le modèle étudiant des états qui comptent.
Ce que la notice ne tranche pas
Il ne nomme aucun domaine de tâche ni famille de modèles, et ne rapporte aucune réplication indépendante. La couverture est également mesurée par rapport à une seule référence, les états visités par l'OPD sur données complètes, de sorte que la métrique décrit la part du territoire de cette exécution qu'une exécution plus petite atteint, plutôt qu'une mesure absolue de la quantité de supervision suffisante.
Le même schéma s'étend à l'OPD multi-enseignants, où 16 requêtes sémantiquement diversifiées par domaine égalent l'entraînement sur données complètes. L'espoir déclaré de l'article est que ces résultats réorientent les travaux vers l'efficacité en étapes de la méthode et incitent à un nouvel examen des données et des mécanismes derrière ses récents succès dans le post-entraînement à la frontière.
Réduire un jeu d'entraînement à 16 requêtes et égaler la référence est un résultat étrange pour une technique dont les récents succès à la frontière sont en partie attribués aux données par l'article. Son interprétation est que davantage de données change la vitesse à laquelle la supervision arrive, non la quantité que le modèle étudiant peut absorber. Si cela se vérifie, la prochaine série d'améliorations appartient à la boucle d'entraînement, pas au corpus.
- Source : One training query covers 71.5% of what a full LLM distillation dataset does — 2026-09-03
L'essentiel de la tech en 3 minutes chaque matin
Un email, chaque jour ouvré, avec ce qui compte vraiment en IA et en tech.